Tutorial de la API de Telegram Bot

Telegram es más que una aplicación de mensajería. Se ha convertido en una plataforma versátil para la automatización y el desarrollo de servicios interactivos. Especialmente en el ámbito de las aplicaciones de IA y herramientas como n8n, Telegram es cada vez más popular, ya que permite una comunicación bidireccional directa con las personas. Para los desarrolladores que deseen aprovechar estas posibilidades, existen dos enfoques fundamentales: la Bot API y la MTProto-API. La Bot API: el camino estándar para la mayoría de los bots ...
Cortafuegos de Aplicaciones Web (WAF): Una guía práctica

Esta guía trata la función, los componentes y la implementación práctica de un cortafuegos de aplicaciones web (WAF). Definición de un cortafuegos de aplicaciones web Un cortafuegos de aplicaciones web (WAF) es un sistema de seguridad para la supervisión, el filtrado y el bloqueo del tráfico HTTP hacia y desde una aplicación web. A diferencia de un firewall de red tradicional, que opera en las capas de red y de transporte (capa 3 y 4) del modelo OSI y filtra el tráfico principalmente en función de direcciones IP y puertos, un WAF trabaja en la capa de aplicación (capa 7). ...

AsciiDoc & Kroki: una combinación probada para una documentación de software clara

La documentación de software hoy es mucho más que una tarea obligatoria. Es parte del proceso de desarrollo y debe ser tan ágil, versionable y automatizable como el código fuente en sí. Los documentos de oficina clásicos o los wikis propietarios pronto se enfrentan a sus límites. Los cambios son difíciles de rastrear, la colaboración es engorrosa y la integración en pipelines de CI/CD es casi imposible. AsciiDoc y Kroki abordan precisamente estos puntos. Ambas herramientas representan el enfoque Docs-as-Code, en el que la documentación se trata como código fuente. AsciiDoc ofrece un lenguaje textual expresivo para documentación técnica que se puede gestionar en Git y procesar de forma automatizada. Kroki complementa esto con la posibilidad de incrustar diagramas directamente en el documento y renderizarlos automáticamente. De este modo, las desarrolladoras y los desarrolladores pueden utilizar diagramas sin tener que instalar herramientas adicionales. ...

La soberanía de los datos como clave para el éxito de la IA

Introducción: Por qué el dominio de los datos determina el éxito de la IA La inteligencia artificial no surge en el vacío, depende de los datos como combustible. Una red neuronal no puede procesar lenguaje, identificar objetos ni derivar recomendaciones de acción útiles sin una base de datos amplia y de alta calidad. Para las empresas, de ello se deriva una clara consecuencia: quien pierde el control sobre sus propios datos cede el petróleo crudo de la economía digital a plataformas externas. ...

Mapa Mental de Métodos de Aprendizaje Automático

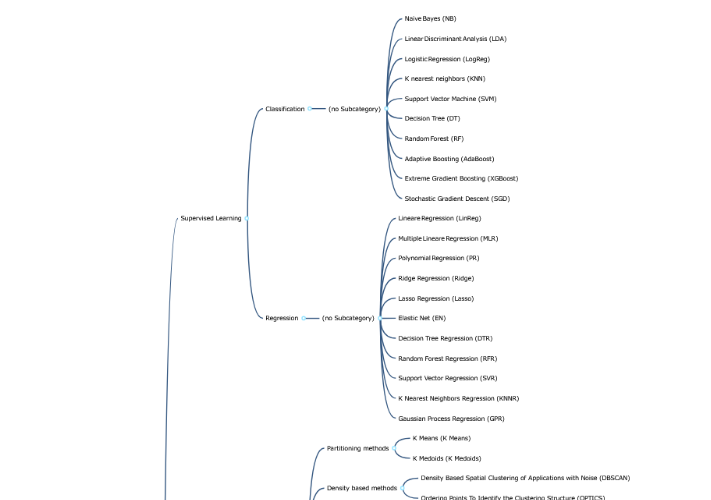
En el aprendizaje automático existen muchos paradigmas y métodos, desde el aprendizaje supervisado y no supervisado, pasando por el semisupervisado y el auto-supervisado, hasta el aprendizaje por transferencia y el aprendizaje por refuerzo. Para mantener la visión general he creado un mapa mental como ayuda de memoria. En el primer nivel están los tipos de aprendizaje, como por ejemplo el aprendizaje supervisado, luego las áreas de tareas, seguidas de los subgrupos temáticos y, por último, procedimientos concretos. ...

Parte 2: Estrategias para mejores resultados con RAG

En Parte 1 vimos cómo una preparación limpia de documentos y un chunking bien pensado son decisivos para la calidad de Retrieval Augmented Generation. Estas bases forman el punto de partida para toda una serie de optimizaciones adicionales que moldean el proceso completo. En la Parte 2 continuamos la serie y nos dedicamos a los siguientes bloques, que se construyen sobre esta base y desarrollan aún más el uso de RAG en la empresa. ...

Parte 1: Estrategias para mejores resultados con RAG

Retrieval Augmented Generation, abreviado RAG, combina el potencial de los modelos de lenguaje con el conocimiento específico de una empresa. Este enfoque permite incorporar documentos y datos internos de manera dirigida en las respuestas sin perder el control sobre la propia información. De este modo, RAG se percibe cada vez más como una tecnología clave para usar modelos de lenguaje de forma segura y con soberanía de datos. En la práctica, sin embargo, pronto se hace evidente que una simple búsqueda vectorial en combinación con un LLM no es suficiente para obtener resultados realmente consistentes y de alta calidad. Para aprovechar al máximo el potencial de RAG, son necesarios métodos y optimizaciones adicionales. ...

Ajuste fino de un modelo Llama-3.x mediante LoRA

Introducción Grandes modelos de lenguaje (Large Language Models, LLMs) como Llama 3.x se entrenan en un costoso proceso de preentrenamiento con ingentes cantidades de texto. Este proceso suele realizarse en hardware especializado como GPUs y TPUs, optimizado para el cálculo en paralelo de grandes redes neuronales. Tras completar el preentrenamiento, los parámetros del modelo quedan congelados y ya no pueden modificarse directamente durante la operación normal. Esto significa que no se puede “corregir” el modelo ni reprogramarlo mediante intervenciones simples. Contenidos como, por ejemplo, hechos sobre personalidades históricas no se almacenan en neuronas individuales accesibles de forma específica. En cambio, esa información se codifica estadísticamente en la totalidad de los pesos del modelo. Esto dificulta enormemente los cambios dirigidos, pues no hay ubicaciones claramente identificables para cada hecho. ...

Cómo una ontología mejora la calidad de las respuestas de los LLM

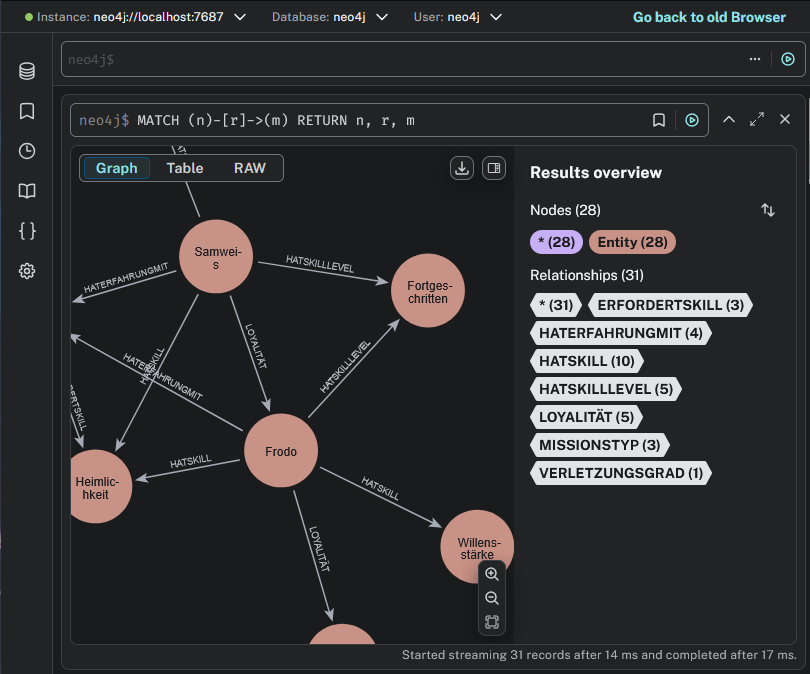
Introducción A más tardar con la llegada de grandes modelos de lenguaje (LLMs) como GPT, muchos se preguntan cómo proporcionar a dichos modelos información estructurada y precisa. Aunque los LLM pueden responder preguntas de forma muy convincente, muchas de sus respuestas se basan únicamente en probabilidades lingüístico-estadísticas, no en razonamientos lógicos o conocimientos explícitos de hechos. Aquí es donde el uso de una ontología aporta un valor añadido sistemático. En la siguiente publicación se muestra, mediante una misión ficticia en el ‘El Señor de los Anillos’-universo, cómo una ontología puede apoyar a un LLM en la respuesta a preguntas complejas. ...

Tutorial de Unstructured.io

Introducción Unstructured.io es un marco de código abierto para el procesamiento estructurado de documentos no estructurados como PDFs, archivos de Word, páginas HTML o correos electrónicos. Su objetivo es extraer contenidos semánticamente útiles de estos formatos heterogéneos, como encabezados, párrafos, tablas o listas, y convertirlos a un formato unificado y legible por máquina. El caso de uso principal es la preparación de datos de texto para su posterior procesamiento por sistemas de IA, especialmente para aquellos con generación aumentada por recuperación (RAG). ...

Pipeline RAG de fabricación propia

Introducción Retrieval Augmented Generation (RAG) es un método de procesamiento de lenguaje natural (PLN), en el que un modelo de lenguaje se combina con conocimiento externo para generar respuestas mejores y más precisas. Un modelo de lenguaje como GPT no solo se consulta sobre su conocimiento interno (entrenamiento), sino que también recibe información contextual de una fuente de conocimiento externa, por ejemplo, una colección de documentos o una base de datos. ...

Análisis lingüístico de texto: una canalización híbrida con Stanza, DeepSeek y Transformers + comparación con Spacy

Introducción Stanza es una biblioteca de PLN de código abierto de la Universidad de Stanford, basada en redes neuronales modernas. Permite el análisis lingüístico exhaustivo de textos en más de 70 idiomas. El objetivo de Stanza es proporcionar un sistema de canalización completo que abarque todos los pasos de procesamiento habituales: tokenización, etiquetado de categorías gramaticales (POS), lematización, análisis sintáctico (dependencias y constituyentes) y reconocimiento de entidades nombradas (NER). Stanza es adecuada tanto para fines de investigación como para aplicaciones productivas, por ejemplo en clasificación de texto, extracción de información o en el preprocesamiento de textos para Retrieval Augmented Generation (RAG). Los modelos están preentrenados, pero también pueden afinarse. Internamente, Stanza se basa en el framework PyTorch. ...

Protocolo de Contexto de Modelo (MCP)

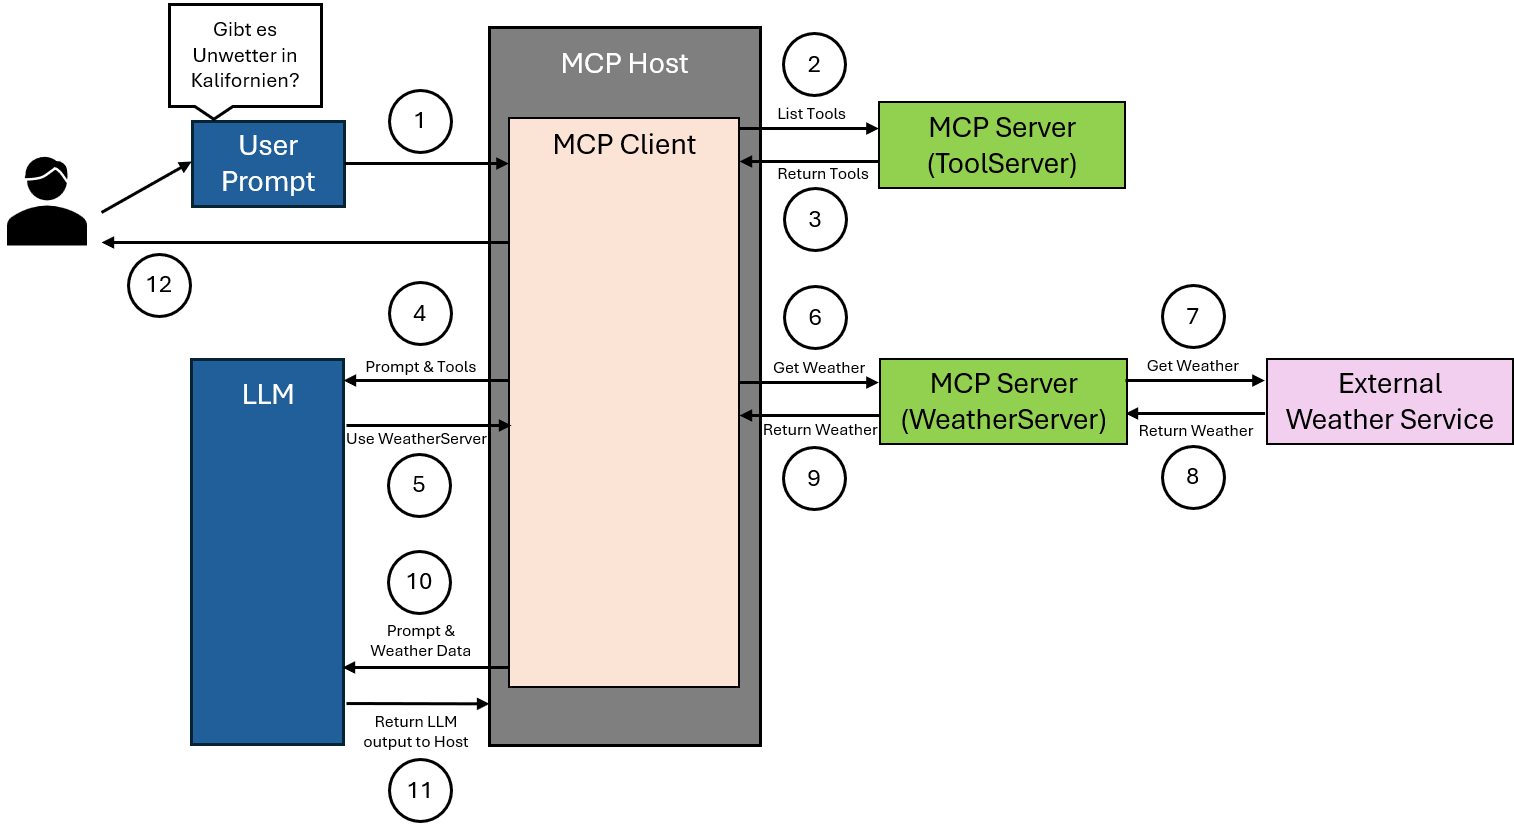
En las aplicaciones de software clásicas, los flujos están predeterminados. Las funciones se llaman en un orden específico, las transferencias están claramente definidas y las decisiones se toman mediante reglas fijas que el desarrollador ha incrustado en el código. La propia aplicación no toma decisiones, solo sigue un proceso rígido. Cuando se quiere integrar un modelo de lenguaje como GPT en un sistema, normalmente hay que asegurarse de que toda la información necesaria se obtenga y prepare de antemano. Por ejemplo: si se necesitan datos meteorológicos actualizados, se escribe una función que consulta una API, procesa la respuesta y envía el texto al modelo. El modelo solo recibe el fragmento de texto final con los datos meteorológicos. No sabe de dónde provienen los datos, qué función los proporcionó ni si están actualizados. Tampoco toma ninguna decisión propia sobre cuándo debe llamarse una función concreta. Simplemente responde basándose en el contexto que se le ha proporcionado. ...

Flujo de trabajo controlado por MCP en n8n

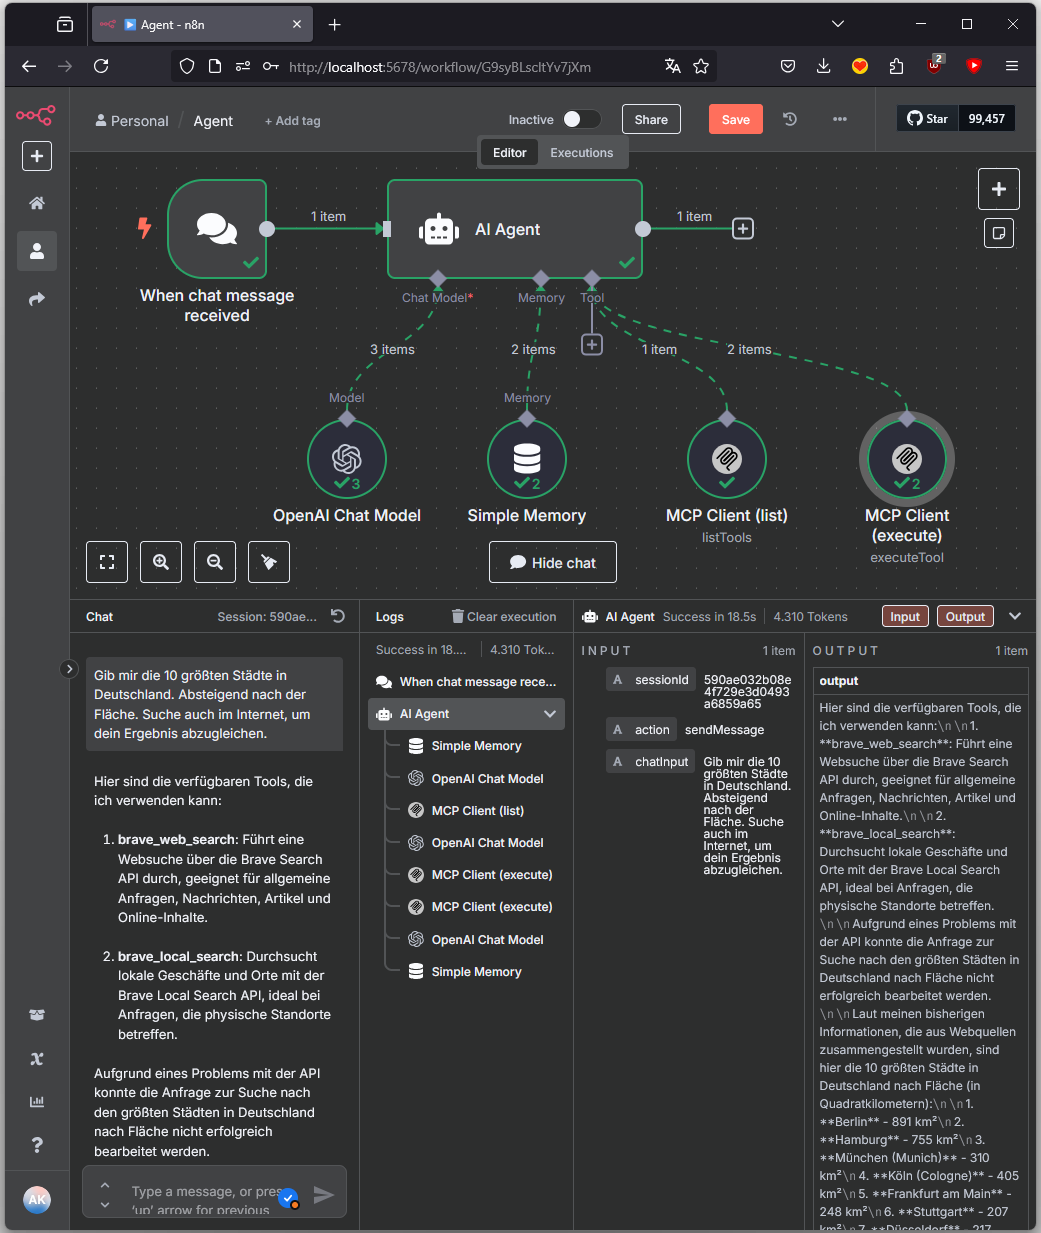
Esta publicación describe la construcción de un sistema de agentes controlado por IA en n8n, que a través del Model Context Protocol (MCP) identifica, selecciona y ejecuta herramientas externas. Objetivo Un usuario hace una entrada en lenguaje natural, p. ej.: “Dame las 10 ciudades más grandes de Alemania. En orden descendente según el área. Busca también en Internet para comparar tu resultado.” El agente detecta la intención, comprueba las herramientas disponibles, decide una selección de herramienta, realiza una búsqueda web si es necesario y genera una respuesta adecuada. El concepto de control subyacente se basa en MCP, un protocolo para la comunicación estructurada de herramientas en sistemas basados en agentes. ...

Tutorial de RAGFlow

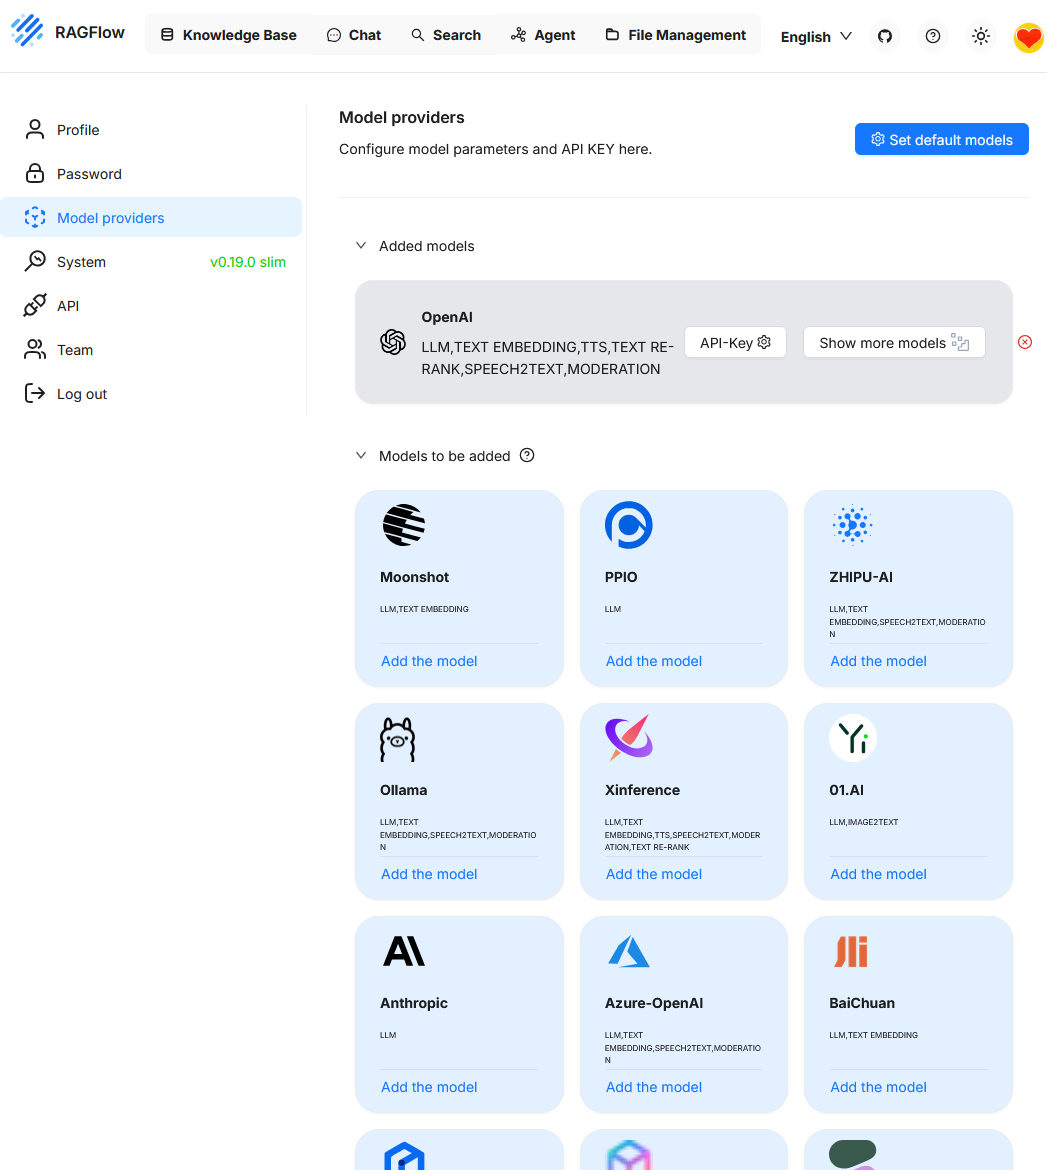
RAGFlow es un framework para la implementación estructurada de aplicaciones de Retrieval Augmented Generation (RAG). Ofrece una arquitectura modular en la que pasos de procesamiento individuales como la importación de documentos, el preprocesamiento de texto, la vectorización, la indexación y la generación de respuestas se pueden configurar y ejecutar por separado. Models La plataforma admite diferentes soluciones de almacenamiento para datos vectoriales y permite la conexión de varios LLM. La lista de LLM compatibles se puede encontrar aquí. ...

Guía práctica de la CLI de Hugging Face

Esta guía se basa en la CLI de Hugging Face desde la versión 0.34.4. En esta versión la sintaxis antigua huggingface-cli se sustituye por el nuevo comando hf. He creado este recordatorio para tener una referencia breve y clara de la CLI de Hugging Face. En lugar de buscar en la documentación oficial, aquí encuentro los comandos, descripciones y ejemplos más importantes de un vistazo. ¿Qué es Hugging Face? Hugging Face es una plataforma de aprendizaje automático. En el centro está el Hugging Face Hub, un repositorio público y privado para modelos de IA, conjuntos de datos y aplicaciones (Spaces). Desarrolladoras y desarrolladores pueden compartir, descargar y reutilizar modelos allí. Además del Hub, Hugging Face ofrece bibliotecas como transformers, datasets y diffusers, que facilitan el uso práctico de modelos de IA. El Hub funciona tanto como mercado como infraestructura para el desarrollo colaborativo. ...

Tutorial de ComfyUI

La inteligencia artificial ha adquirido la capacidad de crear imágenes detalladas y complejas a partir de meras descripciones de texto. La base tecnológica de esto son modelos de IA profundos que actúan como motores digitales para la generación de imágenes. Traducen conceptos escritos en datos visuales y generan, sobre esa base, gráficos completamente nuevos. Para controlar con precisión la generación de imágenes, los usuarios necesitan una interfaz adecuada. Ahí es donde entra en juego ComfyUI. ComfyUI es una interfaz gráfica flexible y potente, diseñada para trabajar con una amplia variedad de modelos de IA. A diferencia de otros programas que ocultan sus procesos tras menús simples, ComfyUI apuesta por un enfoque modular con nodos. Cada paso de la generación de imágenes, desde la elección del modelo hasta la imagen final, se representa como un bloque individual. El usuario conecta visualmente estos bloques y construye así todo el flujo de trabajo. Este método ofrece transparencia y control sobre todo el proceso de generación y permite a los usuarios gobernar el funcionamiento de la IA subyacente hasta el más mínimo detalle. ...

Análisis de documentos no estructurados con "Unstructured"

En el marco de esta prueba se utiliza el framework de código abierto unstructured para evaluar el proceso de extracción de texto de documentos estructurados. El objetivo es comprobar en qué medida unstructured es adecuado para su uso práctico en sistemas de información basados en IA – especialmente con vista a la extracción de texto, el procesamiento semántico (chunking/tokenización) y la posterior generación de embeddings para sistemas de recuperación basados en vectores. ...

Lista de compras digital con React & Supabase

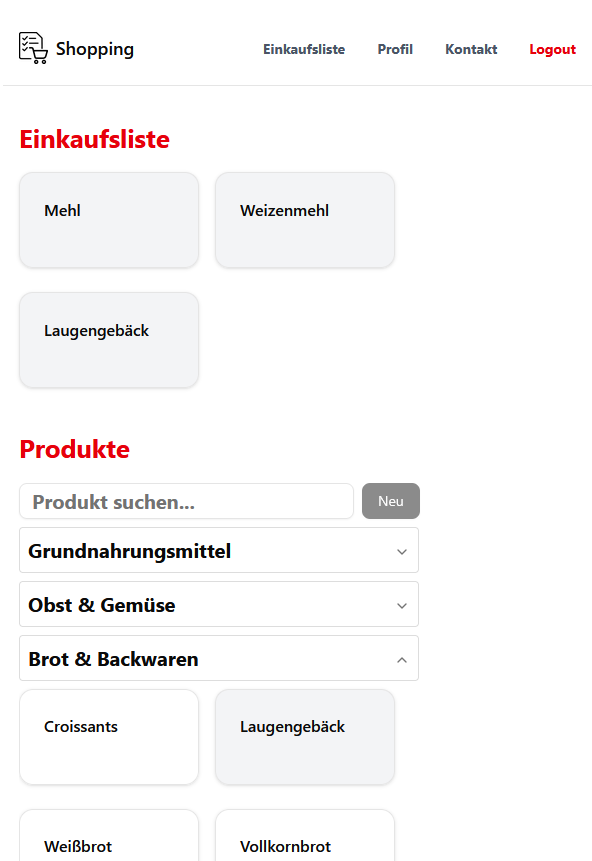
He iniciado este proyecto para aprender React de forma práctica – y no solo seguir tutoriales. Quería implementar un escenario de frontend realista que incluyera requisitos típicos como autenticación de usuarios, gestión de datos, interacciones de usuario y componentes de IU dinámicos. En lugar de crear un backend propio, decidí deliberadamente usar Supabase – una plataforma Backend-as-a-Service que resulta ideal para fines de aprendizaje y prototipado. Así pude concentrarme por completo en el ecosistema de React, incluyendo el enrutamiento, el estado, la estructura de componentes y la interfaz responsiva. ...

Evaluación emocional de música con MindsDB y GPT-4 basada en datos de Spotify

MindsDB es una plataforma de código abierto desarrollada para permitir el aprendizaje automático, el análisis de series temporales y la integración de grandes modelos de lenguaje directamente en los flujos de trabajo tradicionales de bases de datos. La plataforma permite poner la funcionalidad de IA al alcance mediante consultas SQL sencillas, sin que sea necesaria una infraestructura de machine learning por separado. En esta entrada se presenta una de las múltiples funciones de MindsDB: la invocación de un gran modelo de lenguaje (GPT-4) a través de una plantilla predefinida que se rellena dinámicamente con valores de la base de datos. El objetivo es evaluar automáticamente la carga emocional de canciones de un conjunto de datos de Spotify existente. Para ello, se utiliza únicamente una parte del conjunto de funcionalidades de MindsDB, con el fin de conocer el funcionamiento básico y la interacción entre la base de datos y el LLM. ...