En el hundimiento del Titanic, en abril de 1912, murió más de la mitad de las personas a bordo. La plataforma Kaggle ofrece una tabla de 891 pasajeros que muestra quién sobrevivió. Este artículo analiza la tabla con R: ¿qué relación tienen el sexo, la clase y la edad con la supervivencia? Las líneas que empiezan por #> muestran la salida de R.
Cargar los datos
Descargar el conjunto de datos
Los datos pertenecen a la competición de Kaggle Titanic: Machine Learning from Disaster. Para descargarlos hace falta una cuenta gratuita de Kaggle. El archivo train.csv contiene los 891 pasajeros cuyo destino se conoce.
Sin cuenta se puede usar el paquete de R titanic. Contiene la misma tabla con el nombre titanic_train:
install.packages("titanic")
train <- titanic::titanic_train
Leer el conjunto de datos
En el archivo falta la edad, el camarote o el puerto de algunos pasajeros. na.strings hace que R lea los campos vacíos como valor ausente NA y no como texto vacío.
train <- read.csv("train.csv", na.strings = c("", "NA"))Estructura de los datos
dim(train)          # filas y columnas
#> [1] 891  12
str(train)
#> 'data.frame':	891 obs. of  12 variables:
#>  $ PassengerId: int  1 2 3 4 5 6 7 8 9 10 ...
#>  $ Survived   : int  0 1 1 1 0 0 0 0 1 1 ...
#>  $ Pclass     : int  3 1 3 1 3 3 1 3 3 2 ...
#>  $ Name       : chr  "Braund, Mr. Owen Harris" "Cumings, Mrs. John Bradley (Florence Briggs Thayer)" "Heikkinen, Miss. Laina" "Futrelle, Mrs. Jacques Heath (Lily May Peel)" ...
#>  $ Sex        : chr  "male" "female" "female" "female" ...
#>  $ Age        : num  22 38 26 35 35 NA 54 2 27 14 ...
#>  $ SibSp      : int  1 1 0 1 0 0 0 3 0 1 ...
#>  $ Parch      : int  0 0 0 0 0 0 0 1 2 0 ...
#>  $ Ticket     : chr  "A/5 21171" "PC 17599" "STON/O2. 3101282" "113803" ...
#>  $ Fare       : num  7.25 71.28 7.92 53.1 8.05 ...
#>  $ Cabin      : chr  NA "C85" NA "C123" ...
#> $ Embarked : chr "S" "C" "S" "S" ...| Columna | Significado |
|---|---|
| PassengerId | número correlativo |
| Survived | 0 = murió, 1 = sobrevivió |
| Pclass | clase: 1, 2 o 3 |
| Name | apellido, tratamiento y nombre |
| Sex | sexo: female (mujer) o male (hombre) |
| Age | edad en años |
| SibSp | número de hermanos y cónyuges a bordo |
| Parch | número de padres e hijos a bordo |
| Ticket | número de billete |
| Fare | precio del billete en libras esterlinas |
| Cabin | número de camarote |
| Embarked | puerto de embarque: C = Cherburgo, Q = Queenstown, S = Southampton |
head(train[, c("Survived", "Pclass", "Name", "Sex", "Age", "Fare")])
#>   Survived Pclass                                                Name
#> 1        0      3                             Braund, Mr. Owen Harris
#> 2        1      1 Cumings, Mrs. John Bradley (Florence Briggs Thayer)
#> 3        1      3                              Heikkinen, Miss. Laina
#> 4        1      1        Futrelle, Mrs. Jacques Heath (Lily May Peel)
#> 5        0      3                            Allen, Mr. William Henry
#> 6        0      3                                    Moran, Mr. James
#>      Sex Age    Fare
#> 1   male  22  7.2500
#> 2 female  38 71.2833
#> 3 female  26  7.9250
#> 4 female  35 53.1000
#> 5   male  35  8.0500
#> 6   male  NA  8.4583
colSums(is.na(train))   # valores ausentes por columna
#> PassengerId    Survived      Pclass        Name         Sex
#>           0           0           0           0           0
#>         Age       SibSp       Parch      Ticket        Fare
#>         177           0           0           0           0
#>       Cabin    Embarked
#>         687           2
Falta la edad de 177 pasajeros y el camarote de 687. Por eso, todos los análisis de la edad se refieren solo a los 714 pasajeros con edad conocida.
Para que las tablas sean legibles, la columna Survived recibe etiquetas:
train$Estado <- factor(train$Survived, levels = c(0, 1),
                       labels = c("murió", "sobrevivió"))
Supervivientes en total
table(train$Estado)
#>
#>      murió sobrevivió
#>        549        342
round(prop.table(table(train$Estado)) * 100, 1)   # en porcentaje
#>
#>      murió sobrevivió
#>       61.6       38.4
Sobrevivieron 342 pasajeros, es decir, el 38 por ciento. Murieron 549 pasajeros.
cantidad <- table(train$Estado)
pie(cantidad,
    labels = paste0(names(cantidad), ": ", cantidad, " personas"),
    col = c("#c0392b", "#27ae60"),
    main = "Pasajeros supervivientes y fallecidos")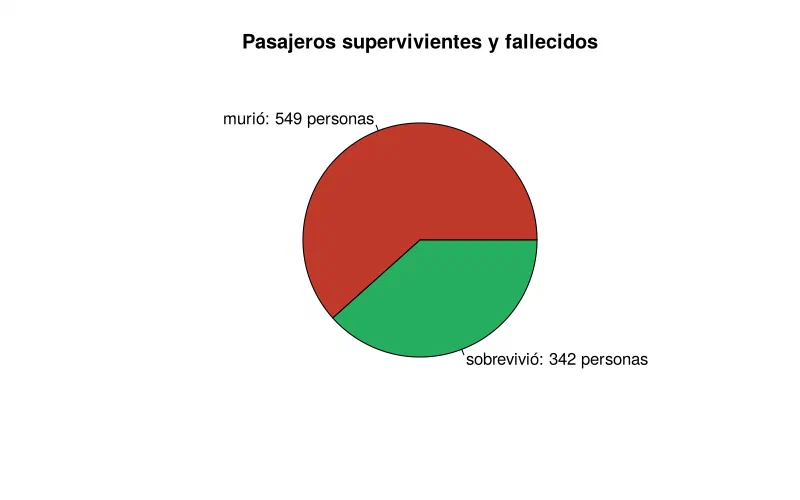
Sexo
Pasajeros por sexo
table(train$Sex)
#>
#> female   male
#> 314 577barplot(table(train$Sex),
names.arg = c("Mujeres", "Hombres"),
col = c("#e377c2", "#1f77b4"),
ylab = "Número de pasajeros", ylim = c(0, 600),
main = "Pasajeros por sexo")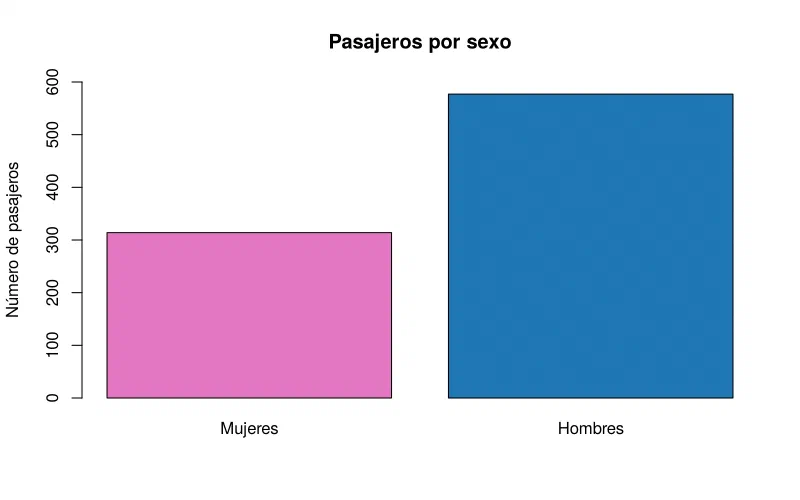
Supervivencia por sexo
table(train$Sex, train$Estado)
#>
#>          murió sobrevivió
#>   female    81        233
#> male 468 109barplot(table(train$Sex, train$Estado),
beside = TRUE,
col = c("#e377c2", "#1f77b4"),
ylab = "Número de pasajeros", ylim = c(0, 500),
legend.text = c("Mujeres", "Hombres"),
args.legend = list(x = "topright"),
main = "Supervivientes y fallecidos por sexo")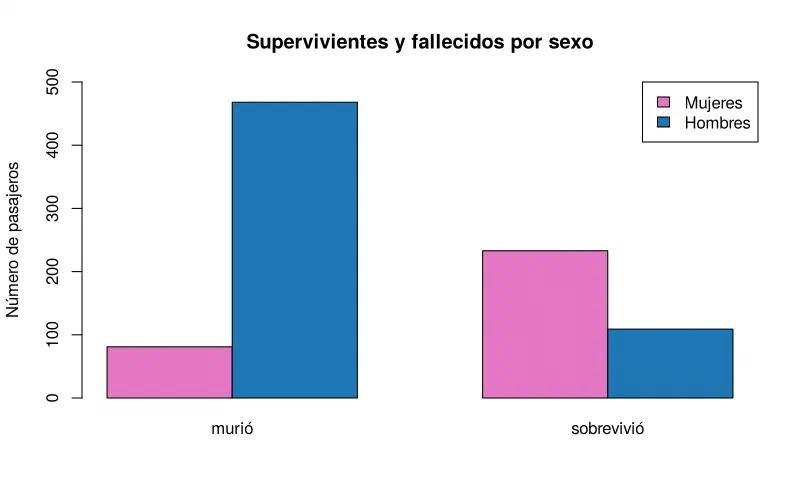
prop.table() convierte la tabla en proporciones. Sin más indicaciones, las proporciones se refieren a los 891 pasajeros:
round(prop.table(table(train$Sex, train$Estado)) * 100, 1)
#>
#>          murió sobrevivió
#>   female   9.1       26.2
#>   male    52.5       12.2
Con margin = 1, las proporciones se refieren a cada fila, es decir, por separado a todas las mujeres y a todos los hombres:
round(prop.table(table(train$Sex, train$Estado), margin = 1) * 100, 1)
#>
#>          murió sobrevivió
#>   female  25.8       74.2
#>   male    81.1       18.9
Sobrevivió el 74 por ciento de las mujeres, pero solo el 19 por ciento de los hombres. Esto corresponde a la regla «mujeres y niños primero» al ocupar los botes salvavidas.
Clase
Pasajeros por clase
table(train$Pclass)
#>
#>   1   2   3
#> 216 184 491
table(train$Estado, train$Pclass)
#>
#>                1   2   3
#>   murió       80  97 372
#> sobrevivió 136 87 119tab <- table(train$Estado, train$Pclass)
colnames(tab) <- paste0(colnames(tab), ".ª clase")
dotchart(tab, pch = 19, col = "#1f77b4", gcolor = "#c0392b",
xlab = "Número de pasajeros", xlim = c(0, 400),
main = "Supervivientes y fallecidos por clase")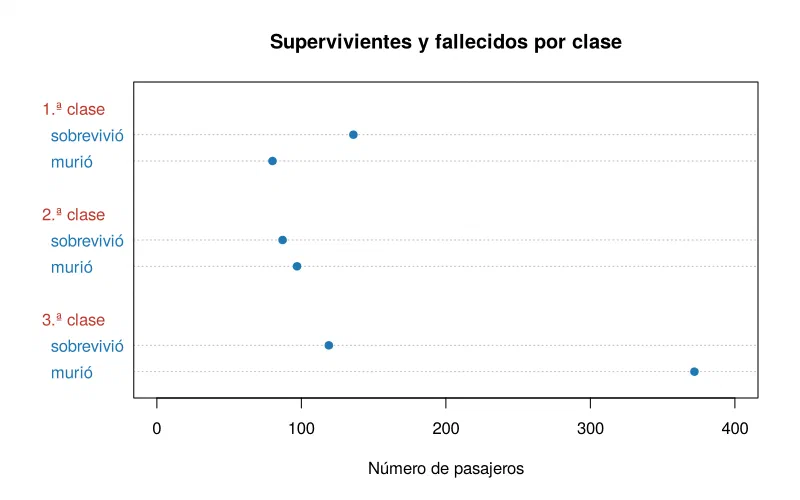
Tasa de supervivencia por clase
margin = 2 hace que las proporciones se refieran a cada columna, es decir, a cada clase. Esto sustituye cálculos a mano como 100 / 216 * 136.
round(prop.table(table(train$Estado, train$Pclass), margin = 2) * 100, 1)
#>
#>                 1    2    3
#>   murió      37.0 52.7 75.8
#>   sobrevivió 63.0 47.3 24.2
En primera clase sobrevivió el 63 por ciento, en segunda el 47 por ciento y en tercera el 24 por ciento.
Sexo y clase a la vez
ftable() muestra de forma clara una tabla con tres características en filas y columnas:
ftable(table(train$Pclass, train$Sex, train$Estado))
#>           murió sobrevivió
#>
#> 1 female      3         91
#>   male       77         45
#> 2 female      6         70
#>   male       91         17
#> 3 female     72         72
#>   male      300         47
En primera y segunda clase sobrevivieron casi todas las mujeres. En tercera clase, solo la mitad.
aggregate(Survived ~ Pclass + Sex, data = train, FUN = mean)
#>   Pclass    Sex  Survived
#> 1      1 female 0.9680851
#> 2      2 female 0.9210526
#> 3      3 female 0.5000000
#> 4      1   male 0.3688525
#> 5      2   male 0.1574074
#> 6      3   male 0.1354467
Como Survived solo contiene 0 y 1, la media es directamente la tasa de supervivencia.
Edad
Distribución de la edad
library(ggplot2)
ggplot(train, aes(x = Age)) +
  geom_histogram(binwidth = 5, boundary = 0, fill = "#1f77b4", colour = "white") +
  labs(x = "Edad en años", y = "Número de pasajeros", title = "Edad de los pasajeros")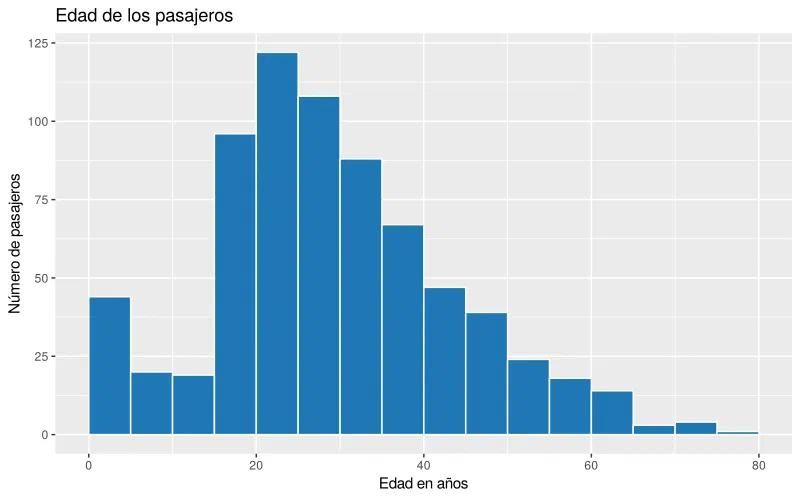
summary(train$Age)
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.    NA's
#>    0.42   20.12   28.00   29.70   38.00   80.00     177
La edad media es de casi 30 años. El pasajero más joven tenía 5 meses y el mayor 80 años.
Edad de las mujeres supervivientes por clase
mujeres <- subset(train, Sex == "female" & Estado == "sobrevivió")
aggregate(Age ~ Pclass, data = mujeres, FUN = median)
#>   Pclass Age
#> 1      1  35
#> 2      2  28
#> 3      3  19
summary(mujeres$Age[mujeres$Pclass == 1])
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.    NA's
#>   14.00   23.25   35.00   34.94   44.00   63.00       9
aggregate() con la fórmula Age ~ Pclass omite automáticamente a los pasajeros sin edad.
Niños
Aquí se consideran niños todos los pasajeros menores de 18 años.
ninos <- subset(train, Age < 18)
nrow(ninos)
#> [1] 113
table(ninos$Pclass)                       # niños por clase
#>
#>  1  2  3
#> 12 23 78
table(ninos$Estado, ninos$Pclass)         # sobrevivieron y murieron por clase
#>
#>               1  2  3
#>   murió       1  2 49
#>   sobrevivió 11 21 29
En primera clase murió un niño, en segunda dos y en tercera 49.
ninas <- subset(ninos, Sex == "female")
table(ninas$Estado, ninas$Pclass)
#>
#>               1  2  3
#>   murió       1  0 16
#>   sobrevivió  7 12 19
Tasa de supervivencia por grupo de edad
train$GrupoEdad <- cut(train$Age, breaks = c(0, 10, 18, 30, 50, 80),
                       labels = c("0 a 9", "10 a 17", "18 a 29",
                                  "30 a 49", "50 a 80"),
                       right = FALSE, include.lowest = TRUE)
tasa <- aggregate(Survived ~ GrupoEdad + Sex, data = train, FUN = mean)
tasa
#>    GrupoEdad    Sex  Survived
#> 1      0 a 9 female 0.6333333
#> 2    10 a 17 female 0.7600000
#> 3    18 a 29 female 0.7282609
#> 4    30 a 49 female 0.7826087
#> 5    50 a 80 female 0.9090909
#> 6      0 a 9   male 0.5937500
#> 7    10 a 17   male 0.1538462
#> 8    18 a 29   male 0.1564246
#> 9    30 a 49   male 0.2134146
#> 10   50 a 80   male 0.1346154

ggplot(tasa, aes(x = GrupoEdad, y = Survived * 100, fill = Sex)) +
  geom_col(position = "dodge") +
  scale_fill_manual(values = c(female = "#e377c2", male = "#1f77b4"),
                    labels = c("Mujeres", "Hombres"), name = NULL) +
  labs(x = "Edad en años", y = "Tasa de supervivencia en porcentaje",
       title = "Tasa de supervivencia por grupo de edad y sexo")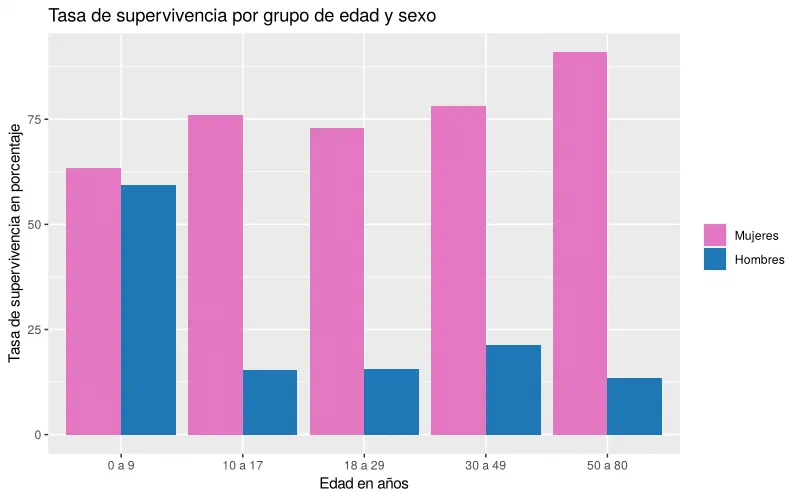
Los niños varones menores de 10 años tuvieron muchas más posibilidades que los hombres adultos. A partir de los 10 años, su tasa de supervivencia baja al nivel de los hombres.
Tratamiento en el nombre
Cada nombre contiene un tratamiento como Mr, Mrs, Miss o Master. Master era el tratamiento para los niños varones. El tratamiento está entre la coma y el primer punto y se puede extraer con una expresión regular:
anyDuplicated(train$Name)    # 0 significa: ningún nombre aparece dos veces
#> [1] 0

train$Tratamiento <- sub(".*, *([^.]+)\\..*", "\\1", train$Name)
sort(table(train$Tratamiento), decreasing = TRUE)
#>
#>           Mr         Miss          Mrs       Master           Dr
#>          517          182          125           40            7
#>          Rev          Col        Major         Mlle         Capt
#>            6            2            2            2            1
#>          Don     Jonkheer         Lady          Mme           Ms
#>            1            1            1            1            1
#>          Sir the Countess
#>            1            1
ifelse() agrupa los tratamientos poco frecuentes como «Otro»:
frecuentes <- c("Mr", "Mrs", "Miss", "Master")
train$Tratamiento <- ifelse(train$Tratamiento %in% frecuentes, train$Tratamiento, "Otro")
table(train$Tratamiento)
#>
#> Master   Miss     Mr    Mrs   Otro
#>     40    182    517    125     27
Supervivencia por tratamiento
table(train$Tratamiento, train$Estado)
#>
#>          murió sobrevivió
#>   Master    17         23
#>   Miss      55        127
#>   Mr       436         81
#>   Mrs       26         99
#>   Otro      15         12
round(prop.table(table(train$Tratamiento, train$Estado), margin = 1) * 100, 1)
#>
#>          murió sobrevivió
#>   Master  42.5       57.5
#>   Miss    30.2       69.8
#>   Mr      84.3       15.7
#>   Mrs     20.8       79.2
#>   Otro    55.6       44.4
Tratamiento y clase
ftable(table(train$Pclass, train$Tratamiento, train$Estado))
#>           murió sobrevivió
#>
#> 1 Master      0          3
#>   Miss        2         44
#>   Mr         70         37
#>   Mrs         1         41
#>   Otro        7         11
#> 2 Master      0          9
#>   Miss        2         32
#>   Mr         83          8
#>   Mrs         4         37
#>   Otro        8          1
#> 3 Master     17         11
#>   Miss       51         51
#>   Mr        283         36
#>   Mrs        21         21
#>   Otro        0          0
Edad por tratamiento
aggregate(Age ~ Tratamiento, data = train, FUN = max)
#>   Tratamiento Age
#> 1      Master  12
#> 2        Miss  63
#> 3          Mr  80
#> 4         Mrs  63
#> 5        Otro  70
El niño de más edad con el tratamiento Master tenía 12 años.
Ganancia de información
La ganancia de información (information gain) indica cuánto reduce una característica la incertidumbre sobre el resultado, aquí sobre la supervivencia. Los árboles de decisión la usan para elegir la característica por la que dividen los datos primero. Se basa en la entropía: la entropía es 0 cuando todos los valores son iguales y 1 cuando dos valores son igual de frecuentes.
entropia <- function(y) {
  p <- table(y) / length(y)
  p <- p[p > 0]
  -sum(p * log2(p))
}

ganancia_informacion <- function(y, x) {
  x <- addNA(factor(x), ifany = TRUE)   # valores ausentes como grupo propio
  partes <- split(y, x)
  condicional <- sum(sapply(partes, \(p) length(p) / length(y) * entropia(p)))
  entropia(y) - condicional
}

entropia(train$Survived)
#> [1] 0.9607079
La entropía de la supervivencia es 0.96, porque supervivientes y fallecidos son casi igual de frecuentes.
Características con muchos valores distintos
Si se aplica la ganancia de información a todas las columnas, Name, Ticket y PassengerId quedan arriba del todo:
columnas <- c("PassengerId", "Name", "Ticket", "Cabin", "Sex", "Pclass", "Embarked")
sort(sapply(train[columnas], \(x) ganancia_informacion(train$Survived, x)),
     decreasing = TRUE)
#> PassengerId        Name      Ticket       Cabin         Sex
#>  0.96070790  0.96070790  0.82593692  0.23838554  0.21766011
#>      Pclass    Embarked
#>  0.08383105  0.02404709
Este resultado es engañoso. Cada nombre aparece una sola vez, así que el nombre predice perfectamente la supervivencia de cada pasajero, sin decir nada sobre un pasajero nuevo. La ganancia de información favorece las características con muchos valores distintos.
Razón de ganancia de información
La razón de ganancia (gain ratio) divide la ganancia de información entre la entropía de la propia característica. Las características con muchísimos valores distintos tienen una entropía alta y obtienen así un valor menor:
razon_ganancia <- function(y, x) {
  x <- addNA(factor(x), ifany = TRUE)
  ganancia_informacion(y, x) / entropia(x)
}

train$CamaroteConocido <- !is.na(train$Cabin)
train$GrupoPrecio <- cut(train$Fare, breaks = c(0, 10, 30, 100, Inf),
                         right = FALSE)

caracteristicas <- c("PassengerId", "Name", "Ticket", "Sex", "Tratamiento", "Pclass",
                     "CamaroteConocido", "GrupoPrecio", "GrupoEdad", "Embarked",
                     "SibSp", "Parch")
resultado <- data.frame(
  caracteristica = caracteristicas,
  ganancia = sapply(train[caracteristicas], \(x) ganancia_informacion(train$Survived, x)),
  razon    = sapply(train[caracteristicas], \(x) razon_ganancia(train$Survived, x)),
  row.names = NULL
)
resultado[order(-resultado$razon), ] |> transform(ganancia = round(ganancia, 3),
                                                    razon = round(razon, 3))
#>      caracteristica ganancia razon
#> 4               Sex    0.218 0.232
#> 5       Tratamiento    0.239 0.143
#> 1       PassengerId    0.961 0.098
#> 2              Name    0.961 0.098
#> 7  CamaroteConocido    0.071 0.092
#> 3            Ticket    0.826 0.089
#> 6            Pclass    0.084 0.058
#> 8       GrupoPrecio    0.083 0.047
#> 11            SibSp    0.033 0.025
#> 10         Embarked    0.024 0.022
#> 12            Parch    0.024 0.021
#> 9         GrupoEdad    0.019 0.008
Según la razón de ganancia, el sexo ocupa el primer puesto, seguido del tratamiento. Name, Ticket y PassengerId pierden la mayor parte de su valor, pero siguen por delante de la clase. Por eso, las columnas que tienen un valor distinto para cada pasajero deben eliminarse de la tabla antes de cualquier análisis. Ninguna de las dos medidas compensa del todo este error.
El paquete FSelector calcula ambos valores con information.gain() y gain.ratio(), pero necesita una instalación de Java.