Web Application Firewall (WAF): Ein praktischer Leitfaden

Dieser Leitfaden behandelt die Funktion, die Komponenten und die praktische Implementierung einer Web Application Firewall (WAF). Definition einer Web Application Firewall Eine Web Application Firewall (WAF) ist ein Sicherheitssystem zur Überwachung, Filterung und Blockierung von HTTP-Datenverkehr zu und von einer Webanwendung. Im Gegensatz zu einer traditionellen Netzwerk-Firewall, die auf den Netzwerk- und Transportschichten (Layer 3 und 4) des OSI-Modells operiert und den Verkehr primär anhand von IP-Adressen und Ports filtert, arbeitet eine WAF auf der Anwendungsebene (Layer 7). ...

AsciiDoc & Kroki: eine bewährte Kombination für klare Softwaredokumentation

Softwaredokumentation ist heute mehr als eine Pflichtaufgabe. Sie ist Teil des Entwicklungsprozesses und muss genauso agil, versionierbar und automatisierbar sein wie der Quellcode selbst. Klassische Office-Dokumente oder proprietäre Wikis stoßen dabei schnell an ihre Grenzen. Änderungen sind schwer nachzuvollziehen, Zusammenarbeit ist umständlich und eine Integration in CI/CD Pipelines ist kaum möglich. AsciiDoc und Kroki greifen genau diese Punkte auf. Beide Werkzeuge stehen für den Ansatz Docs-as-Code, bei dem Dokumentation wie Quellcode behandelt wird. AsciiDoc bietet eine ausdrucksstarke textbasierte Sprache für technische Dokumentation, die sich in Git verwalten und automatisiert verarbeiten lässt. Kroki ergänzt dies um die Möglichkeit, Diagramme direkt im Dokument einzubetten und automatisch zu rendern. So können Entwicklerinnen und Entwickler Diagramme nutzen, ohne zusätzliche Tools installieren zu müssen. ...

Datensouveränität als Schlüssel für erfolgreiche KI

Einleitung: Weshalb die Herrschaft über Daten den Erfolg von KI bestimmt Künstliche Intelligenz entsteht nicht im luftleeren Raum, sie ist auf Daten als Treibstoff angewiesen. Ein neuronales Netz kann ohne eine breite und hochwertige Datengrundlage weder Sprache verarbeiten noch Objekte identifizieren oder sinnvolle Handlungsempfehlungen ableiten. Für Unternehmen ergibt sich daraus eine klare Konsequenz: Wer die Kontrolle über die eigenen Daten verliert, überlässt das Rohöl der digitalen Ökonomie externen Plattformen. Der Begriff der Datensouveränität beschreibt genau diese faktische und rechtliche Herrschaft über die eigenen Datenbestände und geht weit über den klassischen Datenschutz hinaus. Während der Datenschutz primär darauf abzielt, die Grundrechte von Personen durch den Schutz ihrer Informationen zu wahren , stellt die Datensouveränität eine strategische und wirtschaftliche Frage dar. Es geht darum, wem Daten gehören und wer sie auf welche Weise nutzen darf. Hiermit entscheidet sich, ob Daten zu einem wertvollen Wettbewerbsvorteil werden oder unbemerkt in die Wertschöpfungsketten anderer einfließen. ...

Machine Learning Methoden Mindmap

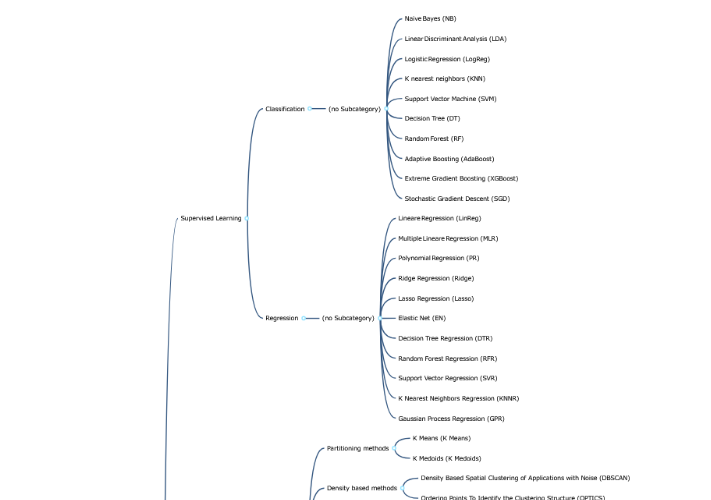
In Machine Learning gibt es viele Paradigmen und Verfahren von Supervised und Unsupervised Learning über Semi und Self supervised bis hin zu Transfer Learning und Reinforcement Learning. Um den Überblick zu behalten habe ich eine Mindmap als Gedankenstütze erstellt. Auf der ersten Ebene stehen die Lernarten wie beispielsweise Supervised Learning, danach die Aufgabenbereiche, gefolgt von den thematischen Untergruppen und schließlich konkrete Verfahren. Die Visualisierung macht deutlich wie breit das Feld ist und erleichtert die Einordnung der einzelnen Verfahren. Sie zeigt nur einen Ausschnitt der Möglichkeiten. Viele weitere Methoden existieren, ich habe mich hier auf die am häufigsten verwendeten und in der Praxis etablierten Verfahren konzentriert. ...

Teil 2: Strategien für bessere Ergebnisse mit RAG

In Teil 1 haben wir gesehen, wie entscheidend eine saubere Dokumentenaufbereitung und ein durchdachtes Chunking für die Qualität von Retrieval Augmented Generation sind. Diese Grundlagen bilden den Startpunkt für eine ganze Reihe weiterer Optimierungen, die den gesamten Prozess prägen. In Teil 2 setzen wir die Reihe fort und widmen uns den nächsten Bausteinen, die auf dieser Basis aufbauen und den Einsatz von RAG im Unternehmen weiterentwickeln. Embedding Domänenspezifische Embeddings Domänenspezifische Embeddings bedeuten, dass Vektordarstellungen von Texten nicht mit allgemein trainierten Embeddingmodellen erzeugt werden, sondern mit Modellen, die auf die Fachsprache und Inhalte einer bestimmten Branche oder eines Unternehmens angepasst wurden. Allgemeine Modelle sind auf sehr große, unspezifische Textmengen trainiert, darunter Bücher, Webseiten, Wikipedia und weitere Quellen. Sie verstehen Alltagssprache und viele Standardkonzepte, verfehlen aber oft die Feinheiten in z.B. juristischen Verträgen, technischen Handbüchern oder medizinischen Befunden. Domänenspezifische Embeddings entstehen durch Feintuning eines vorhandenen Modells mit Daten aus der jeweiligen Fachdomäne oder durch Training eines eigenen Modells auf einem Korpus aus internen Dokumenten, Richtlinien, Protokollen und Handbüchern. ...
Teil 1: Strategien für bessere Ergebnisse mit RAG

Retrieval Augmented Generation, kurz RAG, verbindet die Leistungsfähigkeit von Sprachmodellen mit dem spezifischen Wissen eines Unternehmens. Der Ansatz ermöglicht es, interne Dokumente und Daten gezielt in Antworten einzubeziehen, ohne die Hoheit über die eigenen Informationen zu verlieren. Damit wird RAG zunehmend als Schlüsseltechnologie gesehen, um Sprachmodelle sicher und datensouverän einzusetzen. In der Praxis zeigt sich jedoch schnell, dass eine einfache Vektorsuche in Kombination mit einem LLM nicht ausreicht, um wirklich konsistente und qualitativ hochwertige Ergebnisse zu erzielen. Um das Potenzial von RAG voll auszuschöpfen, sind zusätzliche Methoden und Optimierungen notwendig. ...

Fine-Tuning eines Llama-3.x-Modells via LoRA

Einleitung Große Sprachmodelle (Large Language Models, LLMs) wie Llama 3.x werden in einem aufwendigen Vortrainingsprozess auf gewaltigen Textmengen trainiert. Dieser Prozess erfolgt typischerweise auf spezieller Hardware wie GPUs und TPUs, die für die parallele Berechnung großer neuronaler Netzwerke optimiert sind. Nach Abschluss des Vortrainings sind die Modellparameter eingefroren und können im Regelbetrieb nicht mehr direkt verändert werden. Das bedeutet, dass man das Modell nicht einfach “korrigieren” oder durch einfache Eingriffe gezielt umprogrammieren kann. Inhalte wie zum Beispiel Fakten über historische Persönlichkeiten sind nicht in einzelnen, gezielt ansprechbaren Neuronen gespeichert. Stattdessen sind solche Informationen statistisch verteilt über die Gesamtheit der Modellgewichte codiert. Das erschwert gezielte Änderungen erheblich, da es keine klar identifizierbaren Speicherorte für einzelne Fakten gibt. ...

Wie eine Ontologie die Antwortqualität von LLMs verbessert

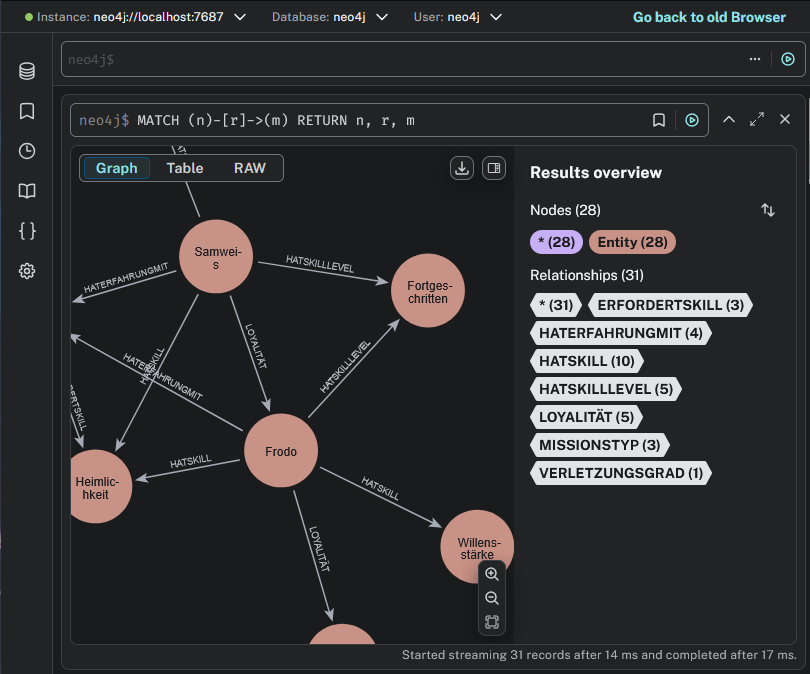
Einleitung Spätestens mit dem Aufkommen großer Sprachmodelle (LLMs) wie GPT stellt sich vielen die Frage, wie man solchen Modellen strukturierte, präzise Informationen zur Verfügung stellen kann. Denn obwohl LLMs in der Lage sind, Fragen sehr überzeugend zu beantworten, beruhen viele ihrer Antworten lediglich auf sprachstatistischen Wahrscheinlichkeiten, nicht auf logischem Schließen oder explizitem Faktenwissen. An dieser Stelle bietet der Einsatz einer Ontologie einen systematischen Mehrwert. Im folgenden Beitrag wird anhand einer fiktiven Mission im „Herr der Ringe“-Universum gezeigt, wie eine Ontologie ein LLM bei der Beantwortung komplexer Fragen unterstützen kann. ...

Unstructured.io Tutorial

Einleitung Unstructured.io ist ein Open-Source-Framework zur strukturierten Aufbereitung unstrukturierter Dokumente wie PDFs, Word-Dateien, HTML-Seiten oder E-Mails. Ziel ist es, aus diesen heterogenen Formaten semantisch verwertbare Inhalte zu extrahieren, etwa Überschriften, Absätze, Tabellen oder Listen, und sie in ein einheitliches, maschinenlesbares Format zu überführen. Der Hauptanwendungsfall liegt in der Vorbereitung von Textdaten für nachgelagerte KI-Verarbeitung, insbesondere für Systeme mit Retrieval-Augmented Generation (RAG). Der typische Einsatz erfolgt im Rahmen von Dokumentenanalyse, Wissensmanagement oder zur Vorbereitung von Eingaben für Embedding-Modelle. Dabei kommen mehrere Verarbeitungsschritte zum Einsatz. Diese vier Schritte bilden den Kern der Unstructured.io-Pipeline und werden bei jeder regulären Nutzung der Bibliothek durchlaufen. ...

RAG-Pipeline im Eigenbau

Einleitung Retrieval Augmented Generation (RAG) ist ein Verfahren der natürlichen Sprachverarbeitung (NLP), bei dem ein Sprachmodell mit externem Wissen kombiniert wird, um bessere und präzisere Antworten zu erzeugen. Ein Sprachmodell wie GPT wird nicht nur auf seinem internen Wissen (Training) befragt, sondern erhält zusätzlich kontextbezogene Informationen aus einer externen Wissensquelle, z. B. einer Dokumentensammlung oder Datenbank. Der Beitrag erläutert den Aufbau und die Entwicklung einer RAG-Pipeline im Rahmen eines Lernprojekts. Ziel war es, ein System zu entwickeln, das den Inhalt eines PDF-Dokuments verarbeitet und es ermöglicht, in einem interaktiven Chat Fragen zu diesem Dokument zu stellen. Die Anwendung entstand aus dem Wunsch, die Funktionsweise und das Zusammenspiel der einzelnen Komponenten einer RAG-Anwendung praktisch nachzuvollziehen. ...

Linguistische Textanalyse: Eine hybride Pipeline mit Stanza, DeepSeek und Transformers + Spacy Vergleich

Einleitung Stanza ist eine Open Source NLP Bibliothek der Stanford University, die auf modernen neuronalen Netzen basiert. Sie ermöglicht die umfassende linguistische Analyse von Texten in über 70 Sprachen. Ziel von Stanza ist es, ein vollständiges Pipeline System bereitzustellen, das alle gängigen Verarbeitungsschritte umfasst: Tokenisierung, Wortartenbestimmung (POS), Lemmatisierung, syntaktische Analyse (Abhängigkeiten und Konstituenten) sowie Named Entity Recognition (NER). Stanza eignet sich sowohl für Forschungszwecke als auch für produktive Anwendungen, etwa bei der Textklassifikation, Informationsextraktion oder dem Vorverarbeiten von Texten für Retrieval Augmented Generation (RAG). Die Modelle sind vortrainiert, können aber auch feinjustiert werden. Intern basiert Stanza auf dem PyTorch Framework. ...

Model Context Protokoll (MCP)

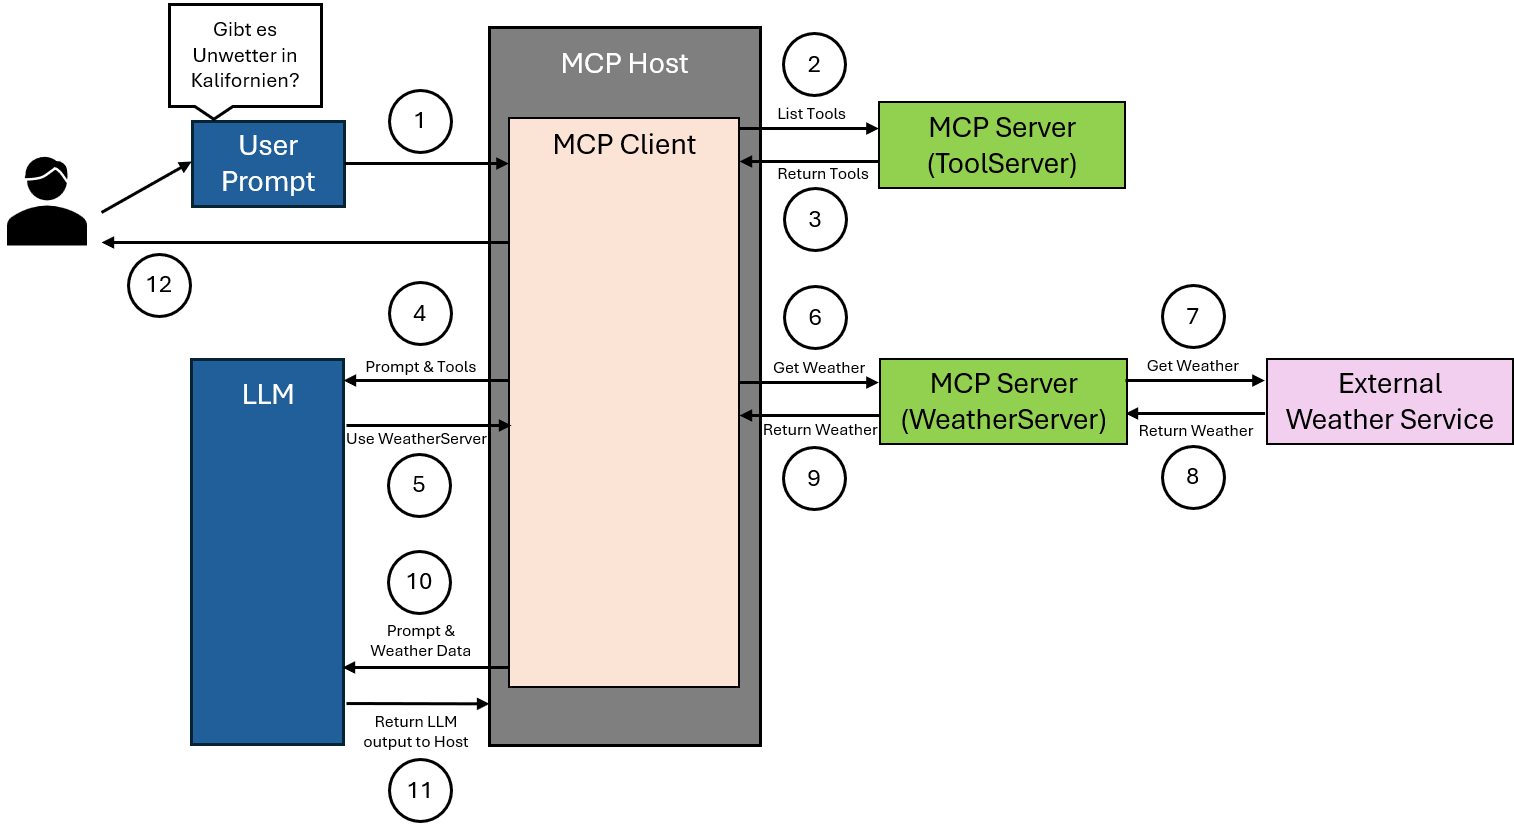
In klassischen Softwareanwendungen sind Abläufe fest vorgegeben. Funktionen werden in bestimmter Reihenfolge aufgerufen, Übergaben sind klar definiert, und Entscheidungen werden durch feste Regeln getroffen, die der Entwickler im Code verankert hat. Die Anwendung selbst trifft keine Entscheidungen, sie folgt nur einem starren Ablauf. Wenn man ein Sprachmodell wie GPT in ein System einbinden möchte, muss man normalerweise dafür sorgen, dass alle benötigten Informationen vorher beschafft und vorbereitet werden. Zum Beispiel: Wenn aktuelle Wetterdaten gebraucht werden, schreibt man eine Funktion, die eine API abfragt, die Antwort verarbeitet und den Text an das Modell weitergibt. Das Modell bekommt nur den fertigen Textausschnitt mit den Wetterdaten. Es weiß nicht, woher die Daten stammen, welche Funktion sie geliefert hat oder ob sie aktuell sind. Es trifft auch keine eigene Entscheidung darüber, wann eine bestimmte Funktion aufgerufen werden soll. Es antwortet einfach nur auf Basis des übergebenen Kontexts. ...

MCP-gesteuerter Workflow in n8n

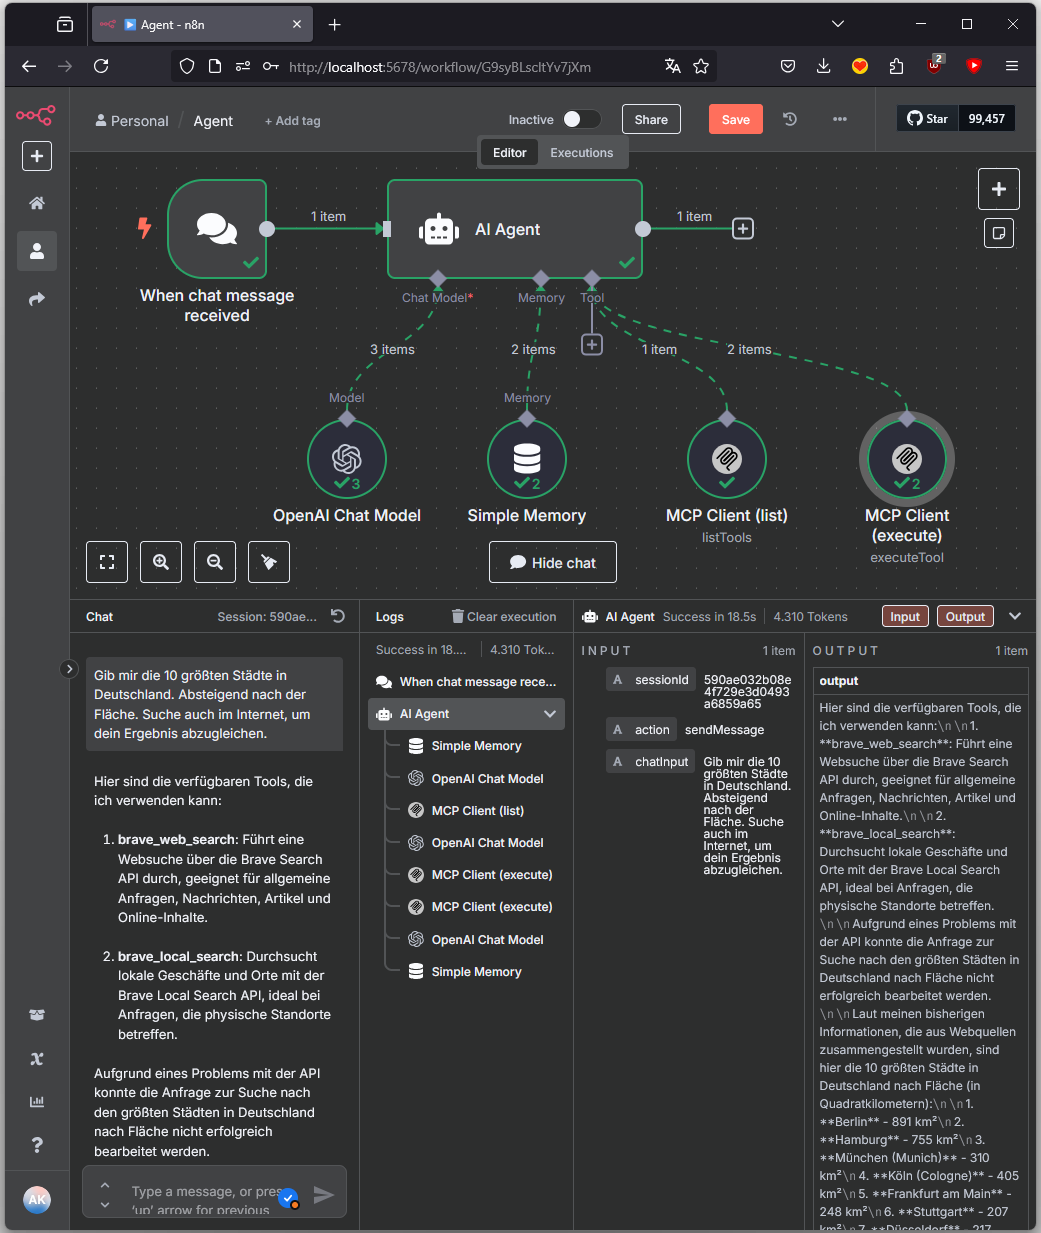
Dieser Beitrag beschreibt den Aufbau eines KI-gesteuerten Agentensystems in n8n, das über das Model Context Protocol (MCP) externe Tools identifiziert, auswählt und ausführt. Zielsetzung Ein Benutzer stellt eine natürliche Spracheingabe, z. B.: “Gib mir die 10 größten Städte in Deutschland. Absteigend nach der Fläche. Suche auch im Internet, um dein Ergebnis abzugleichen.” Der Agent erkennt die Absicht, prüft verfügbare Werkzeuge, entscheidet über eine Toolauswahl, führt bei Bedarf eine Websuche durch und generiert eine geeignete Antwort. Das zugrunde liegende Steuerungskonzept basiert auf MCP, einem Protokoll zur strukturierten Toolkommunikation in agentenbasierten Systemen. ...

RAGFlow Tutorial

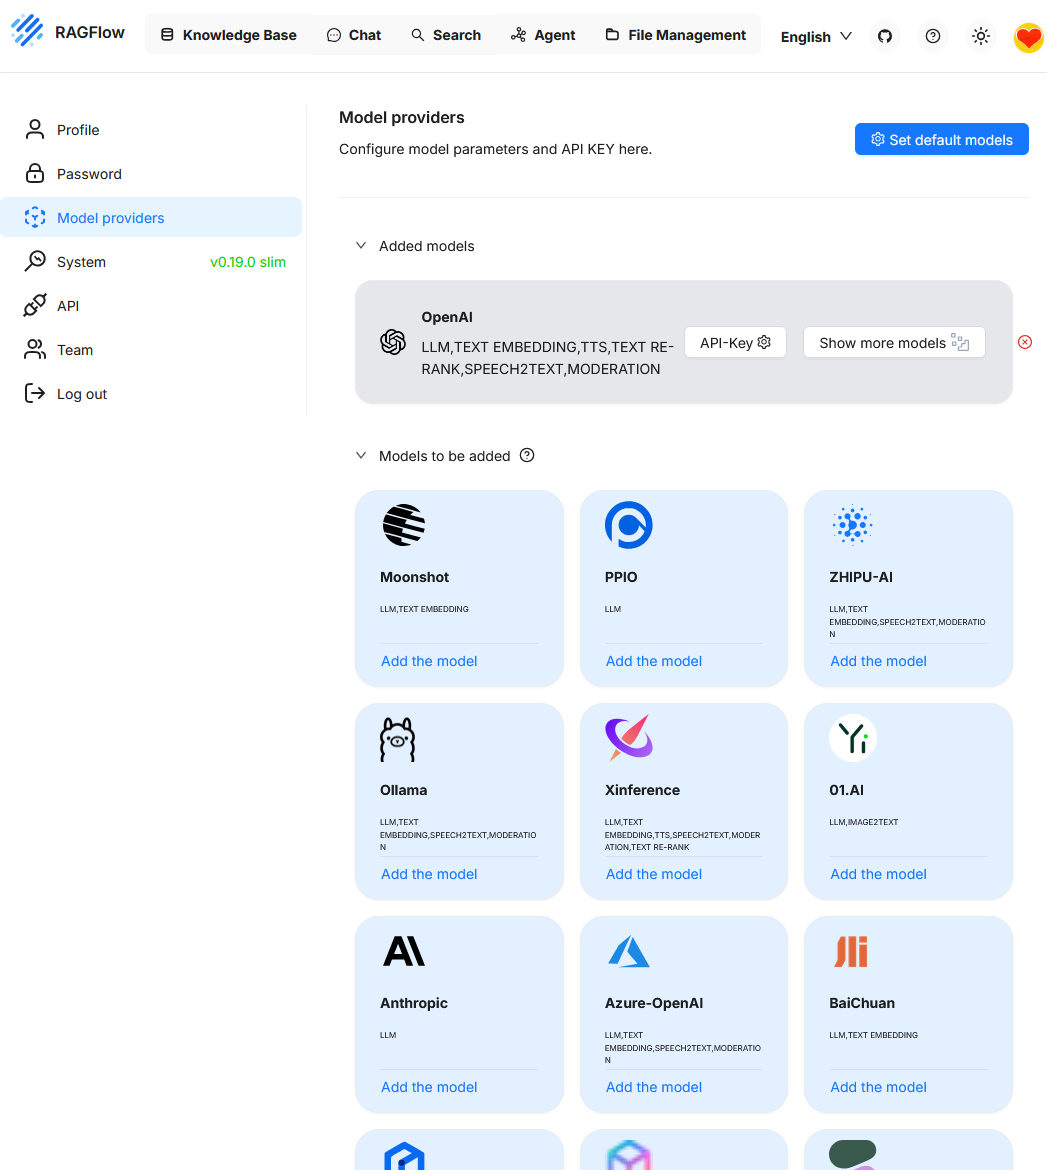
RAGFlow ist ein Framework zur strukturierten Umsetzung von Retrieval Augmented Generation (RAG)-Anwendungen. Es bietet eine modulare Architektur, in der einzelne Verarbeitungsschritte wie Dokumentenimport, Textaufbereitung, Vektorisierung, Indexierung und Antwortgenerierung getrennt konfiguriert und ausgeführt werden können. Models Die Plattform unterstützt unterschiedliche Speicherlösungen für Vektordaten und erlaubt die Anbindung verschiedener LLMs. Die Liste der unterstützten LLM sind hier zu finden. Spalte Bedeutung Provider Anbieter oder Quelle des Modells. Kann ein Cloud-Dienst (z.B. OpenAI) oder ein Modellentwickler (z.B. Cohere, BAAI) sein. Chat Unterstützt dialogorientierte Sprachmodelle, die für Konversation oder Antwortgenerierung verwendet werden. Embedding Bietet Einbettungsmodelle zur Umwandlung von Texten in Vektoren für semantische Suche oder Klassifikation. Rerank Modelle zur Re-Rangierung bereits gefundener Treffer, um relevantere Ergebnisse weiter oben anzuzeigen. Img2txt Modelle zur Bildbeschreibung: Wandeln ein Bild in einen beschreibenden Text um. Speech2txt Modelle zur Umwandlung von gesprochener Sprache in geschriebenen Text (ASR - Automatic Speech Recognition). TTS Text-to-Speech: Wandelt geschriebenen Text in synthetische Sprache um. In der Tabelle noch ohne Unterstützung. OpenAI stellt keine Unterstützung für die Funktion „Rerank“ bereit. ...

Hugging Face CLI Praxisleitfaden

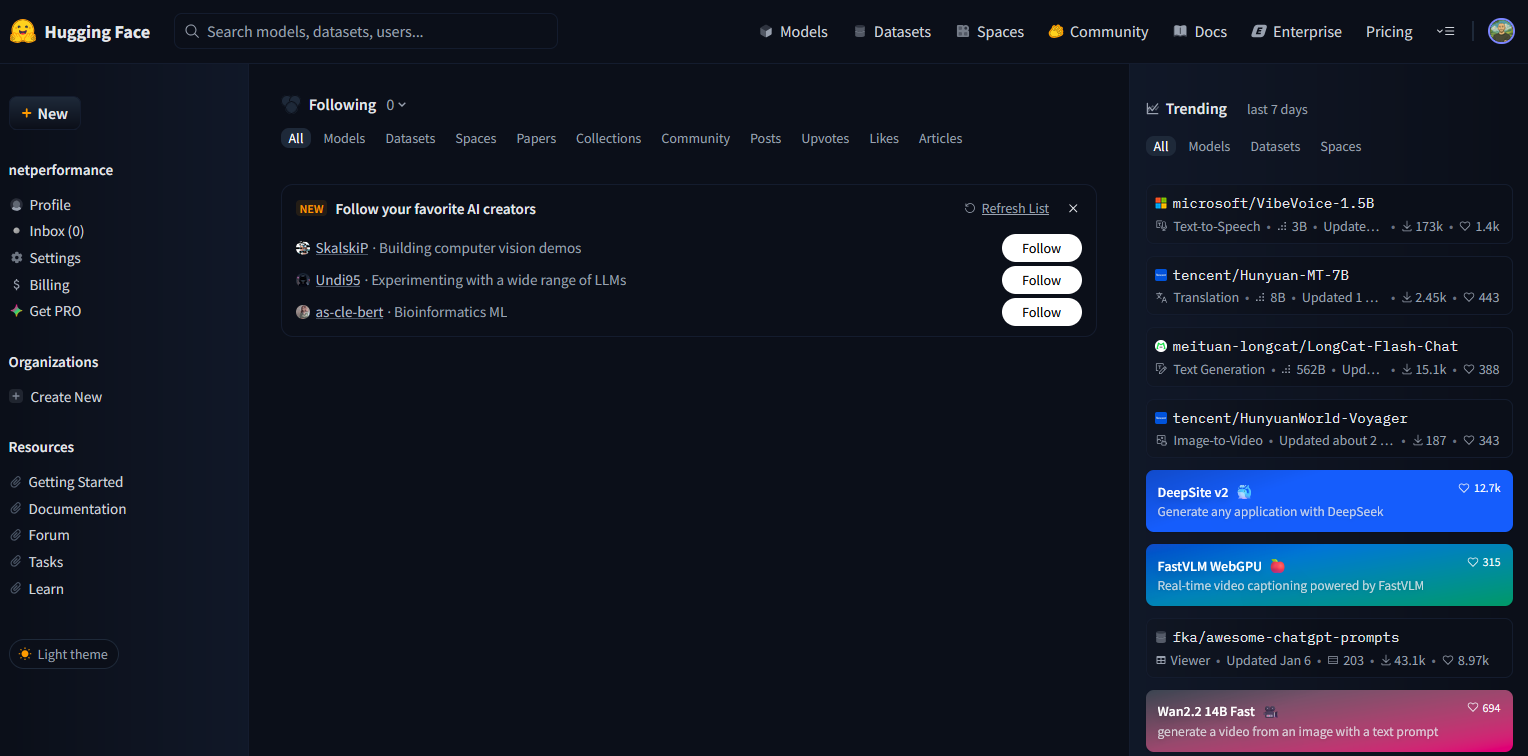
Diese Anleitung basiert auf der Hugging Face CLI ab Version 0.34.4. In dieser Version wird die alte Syntax huggingface-cli durch den neuen Befehl hf ersetzt. Ich habe diese Gedankenstütze erstellt, um eine kurze und übersichtliche Referenz zur Hugging Face CLI zu haben. Statt in der offiziellen Dokumentation suchen zu müssen, finde ich hier die wichtigsten Befehle, Beschreibungen und Beispiele auf einen Blick. Was ist Hugging Face? Hugging Face ist eine Plattform für maschinelles Lernen. Im Mittelpunkt steht der Hugging Face Hub, ein öffentlicher und privater Speicherort für KI-Modelle, Datensätze und Anwendungen (Spaces). Entwicklerinnen und Entwickler können dort Modelle teilen, herunterladen und weiterverwenden. Neben dem Hub bietet Hugging Face auch Bibliotheken wie transformers, datasets und diffusers, die den praktischen Einsatz von KI-Modellen erleichtern. Der Hub dient damit sowohl als Marktplatz als auch als Infrastruktur für gemeinschaftliche Entwicklung. ...

ComfyUI Tutorial

Die künstliche Intelligenz hat die Fähigkeit erlangt, aus reinen Textbeschreibungen detailreiche und komplexe Bilder zu erschaffen. Die technologische Grundlage hierfür bilden tiefgreifende KI Modelle, die als digitale Motoren für die Bilderzeugung fungieren. Sie übersetzen geschriebene Konzepte in visuelle Daten und generieren auf dieser Basis völlig neue Grafiken. Um die Bilderzeugung präzise zu steuern, benötigen Anwender eine passende Benutzeroberfläche. An dieser Stelle kommt ComfyUI ins Spiel. ComfyUI ist eine flexible und leistungsstarke grafische Oberfläche, die für die Arbeit mit einer Vielzahl von KI Modellen konzipiert wurde. Im Gegensatz zu anderen Programmen, die ihre Prozesse hinter einfachen Menüs verbergen, setzt ComfyUI auf einen modularen Ansatz mit Knoten. Jeder Schritt der Bilderzeugung, von der Modellwahl bis zum fertigen Bild, wird als einzelner Baustein dargestellt. Der Anwender verbindet diese Bausteine visuell miteinander und konstruiert so den gesamten Arbeitsablauf selbst. Diese Methode bietet Transparenz und Kontrolle über den gesamten Generierungsprozess und ermöglicht es Nutzern, die Funktionsweise der zugrundeliegenden KI bis ins kleinste Detail zu steuern. ...

Analyse unstrukturierter Dokumente mit "Unstructured"

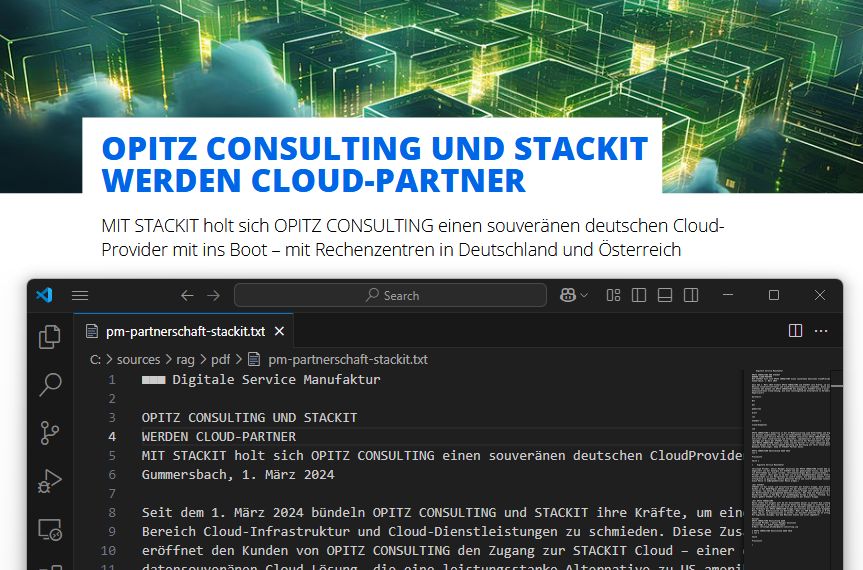
Im Rahmen dieses Tests wird das Open-Source-Framework unstructured eingesetzt, um den Extraktionsprozess von Text aus strukturierten Dokumenten zu evaluieren. Ziel ist es, zu prüfen, inwieweit sich unstructured für den praktischen Einsatz in KI-basierten Informationssystemen eignet – insbesondere mit Blick auf die Textextraktion, semantische Aufbereitung (Chunking/Tokenisierung) und anschließende Embedding-Erzeugung für Vektor-basierte Retrieval-Systeme. Hier sieht man ein Beispiel einer PDF-Datei, die für die Analyse mit unstructured verwendet wurde. pm-partnerschaft-stackitHerunterladen Zur Ausführung der unstructured-Bibliothek wird das offizielle Docker-Image verwendet. Dieses enthält alle erforderlichen Abhängigkeiten (z. B. Tesseract, Poppler, Python-Bibliotheken) und ermöglicht eine sofortige Nutzung ohne lokale Python-Installation. ...

Digitale Einkaufsliste mit React & Supabase

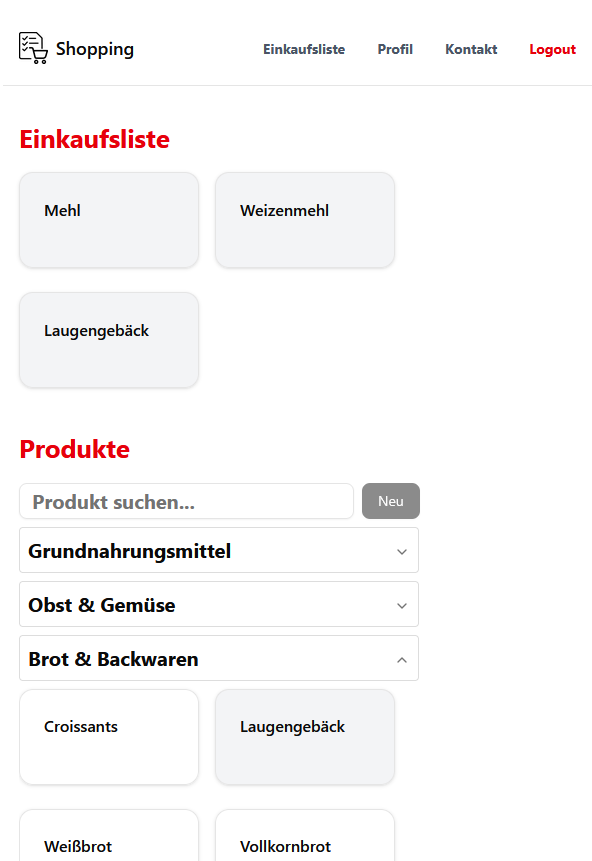
Ich habe dieses Projekt gestartet, um React praxisnah zu lernen – und nicht nur Tutorials zu verfolgen. Dabei wollte ich ein realistisches Frontend-Szenario umsetzen, das typische Anforderungen wie Benutzerauthentifizierung, Datenverwaltung, Benutzerinteraktionen und dynamische UI-Komponenten beinhaltet. Anstatt ein eigenes Backend zu bauen, habe ich mich bewusst für Supabase entschieden – eine Backend-as-a-Service-Plattform, die sich ideal für Lern- und Prototyping-Zwecke eignet. Dadurch konnte ich mich voll auf das React-Ökosystem konzentrieren, inklusive Routing, Zustand, Komponentenstruktur und responsiver Oberfläche. ...

Emotionale Musikbewertung mit MindsDB und GPT-4 anhand von Spotify-Daten

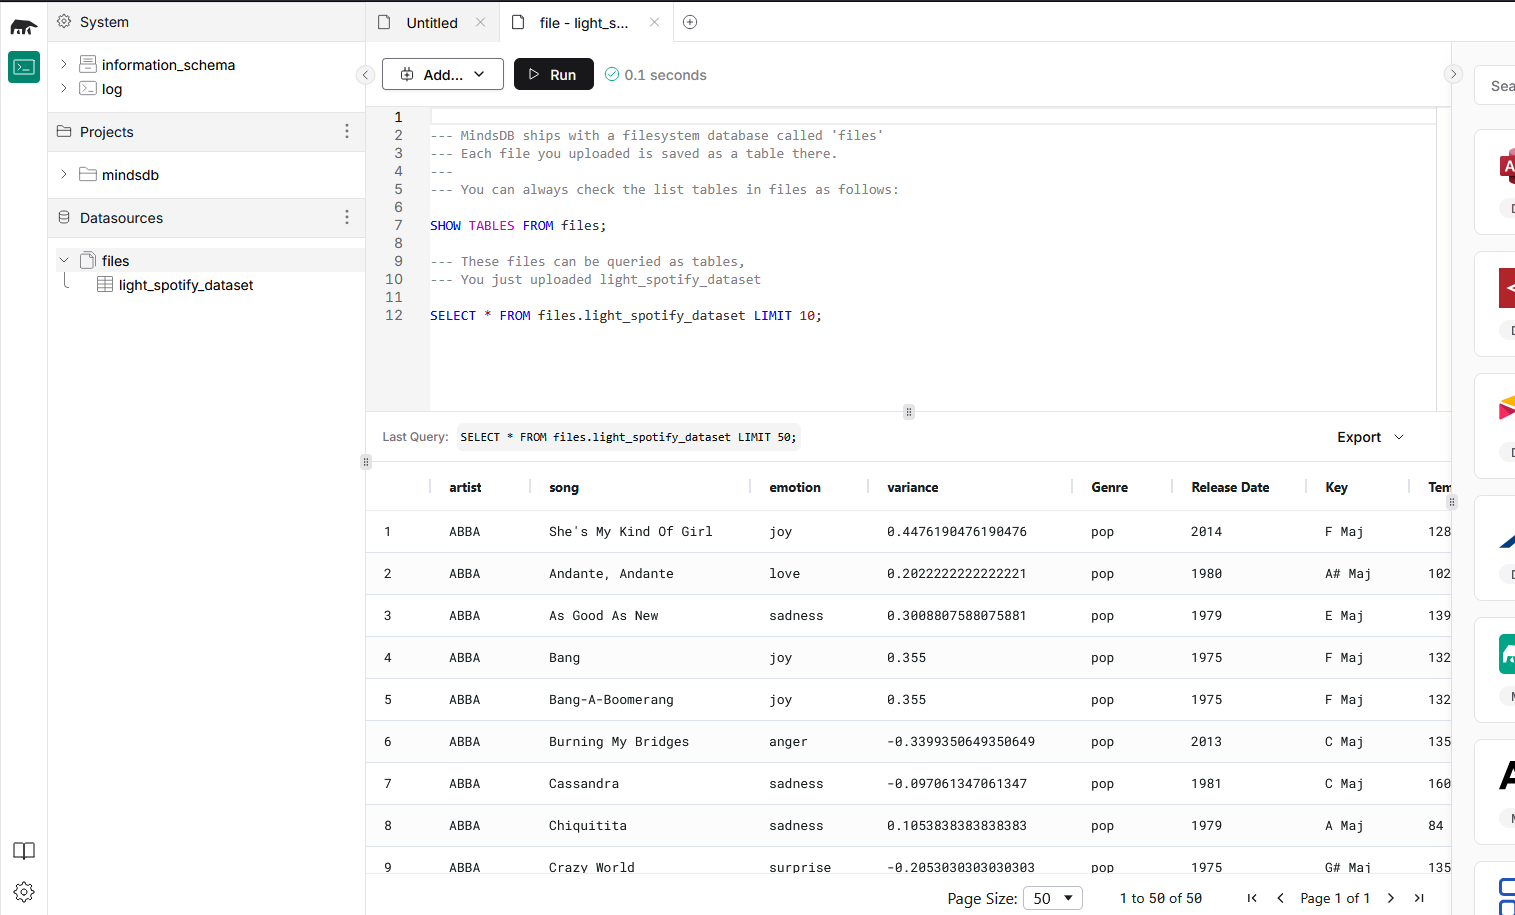
MindsDB ist eine Open-Source-Plattform, die entwickelt wurde, um maschinelles Lernen, Zeitreihenanalysen und die Integration großer Sprachmodelle direkt in klassische Datenbank-Workflows zu ermöglichen. Die Plattform erlaubt es, KI-Funktionalität über einfache SQL-Abfragen zugänglich zu machen, ohne dass eine separate Machine-Learning-Infrastruktur notwendig ist. In diesem Beitrag wird eine der zahlreichen Funktionen von MindsDB vorgestellt: der Aufruf eines großen Sprachmodells (GPT-4) über ein vordefiniertes Template, das dynamisch mit Datenbankwerten befüllt wird. Ziel ist es, die emotionale Wirkung von Songs aus einem bestehenden Spotify-Datensatz automatisch bewerten zu lassen. Dabei wird lediglich ein Teil des gesamten Funktionsumfangs von MindsDB genutzt, um die grundlegende Arbeitsweise und das Zusammenspiel von Datenbank und LLM kennenzulernen. ...

Echtzeit-Gesichtsanimation für Metahumans mit Live Link Face in Unreal Engine 5

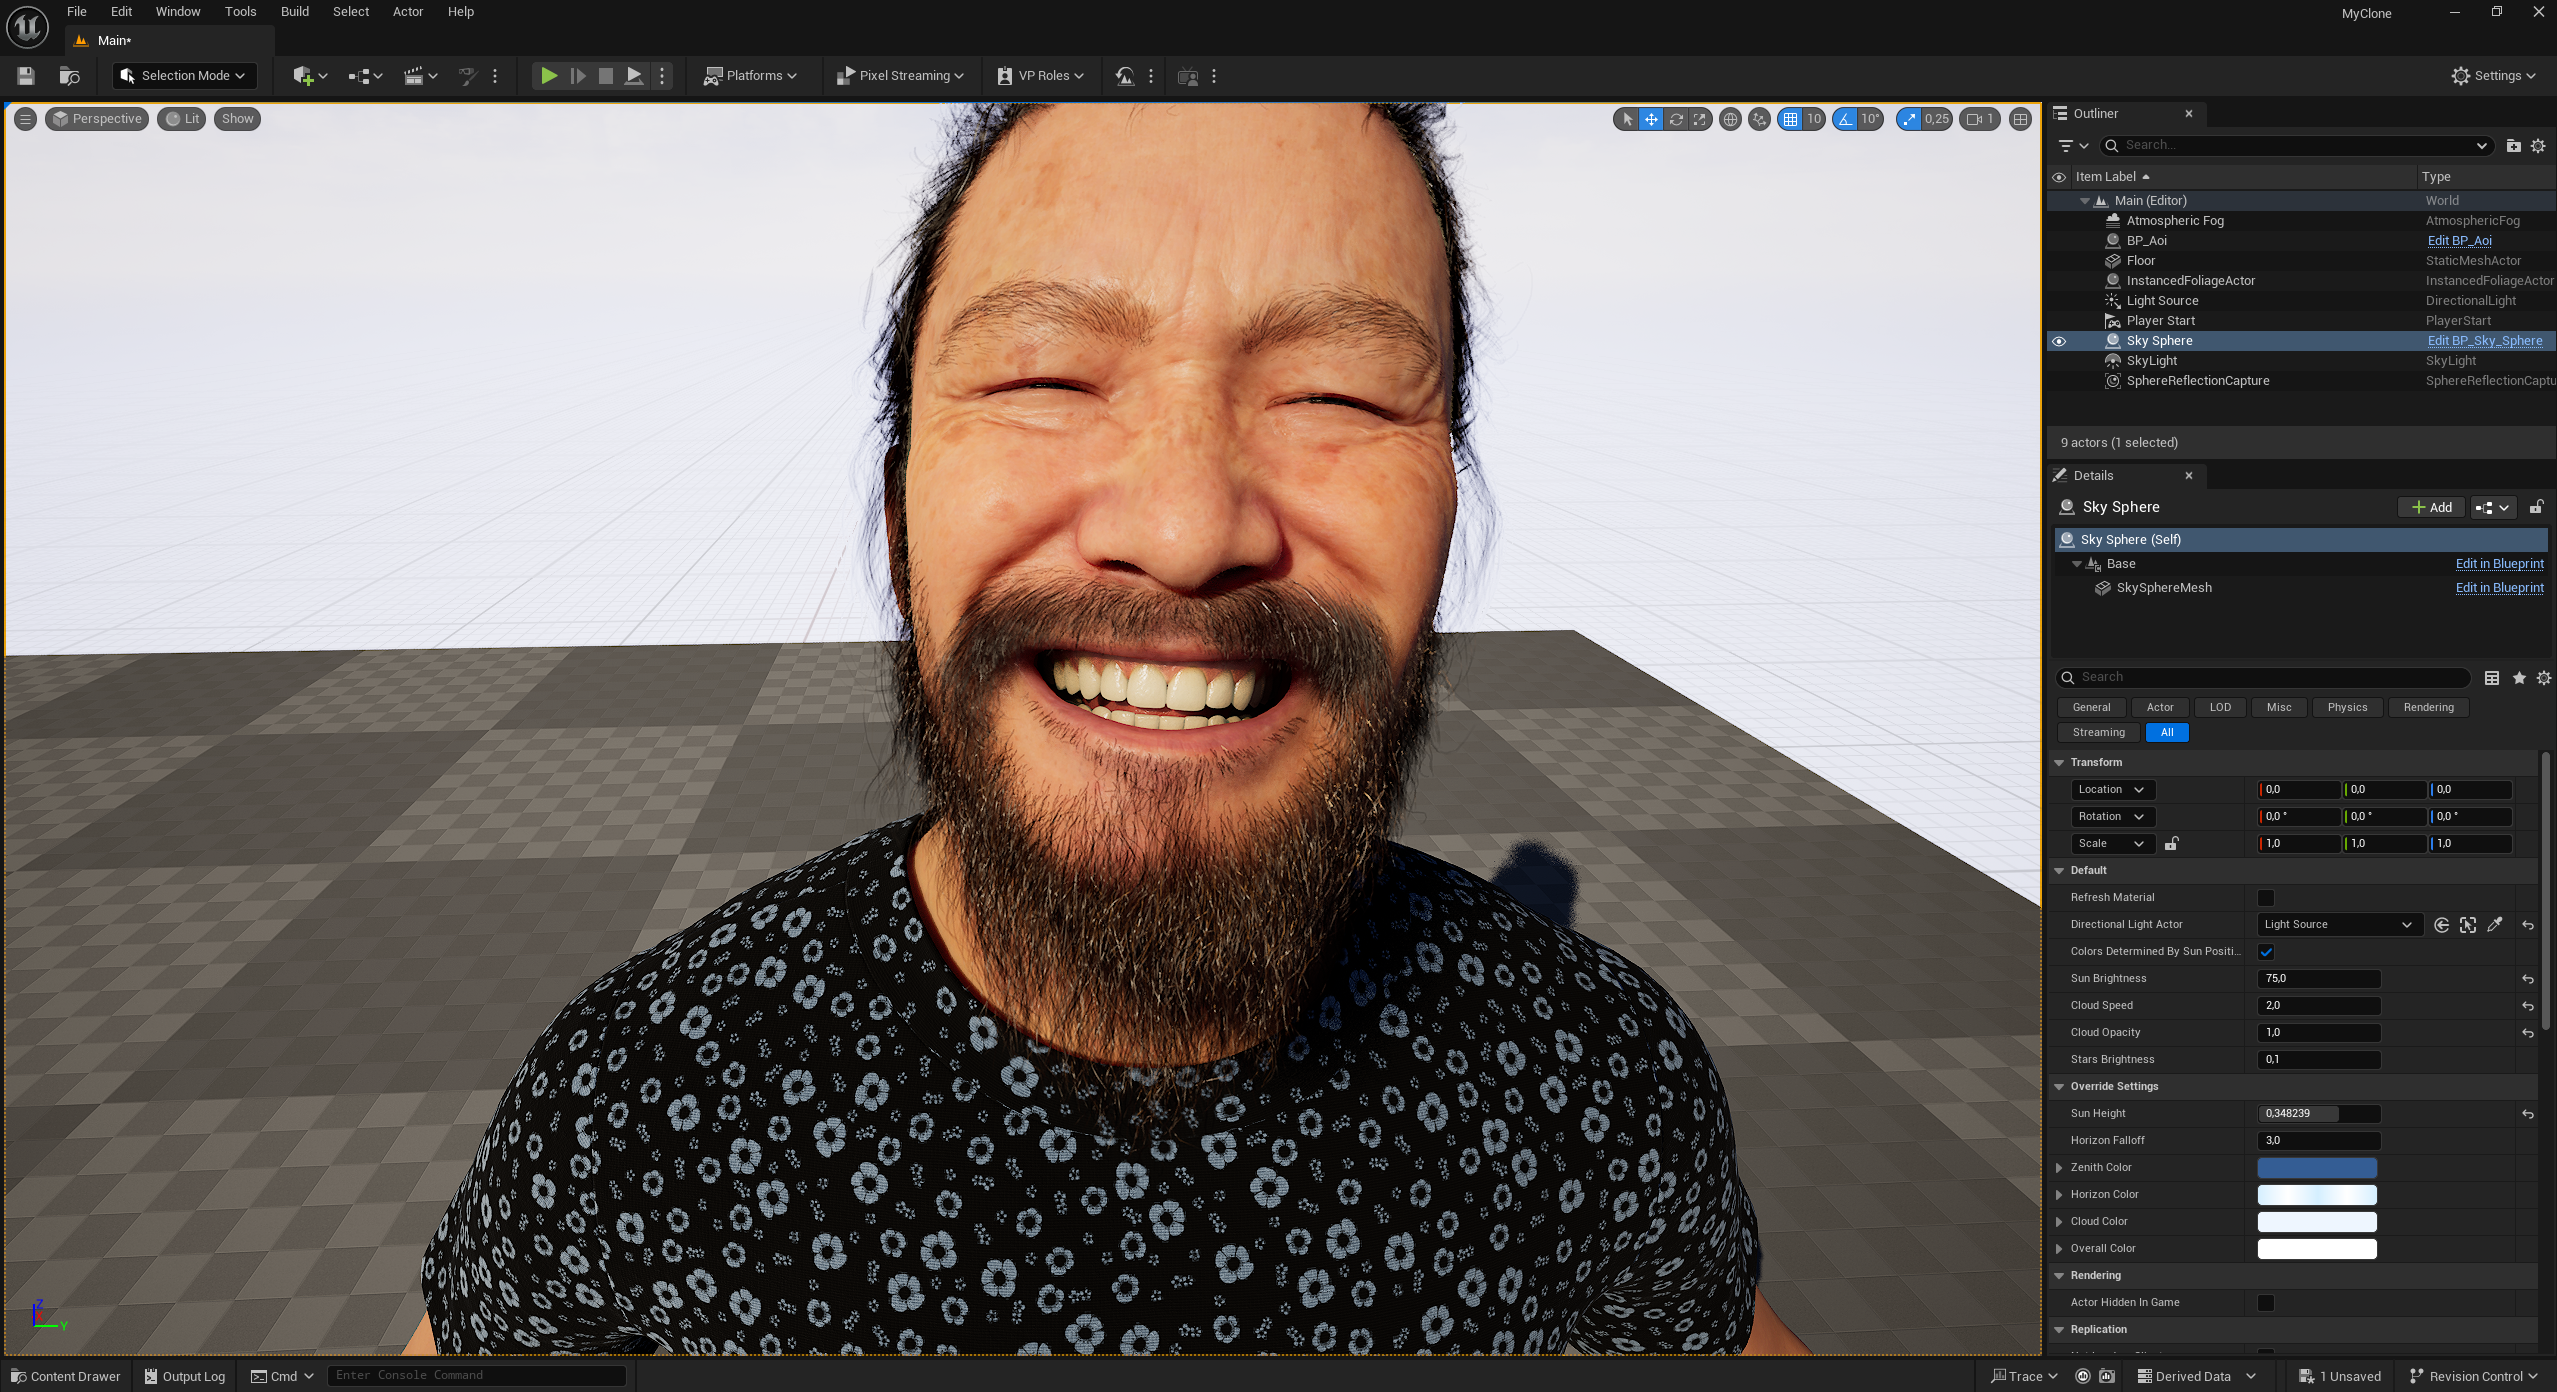
Die Übertragung von Gesichtsausdrücken in Echtzeit auf digitale Charaktere ist ein wichtiger Bestandteil moderner Animations- und Visualisierungsprozesse. Mit der Live Link Face App von Epic Games und Unreal Engine 5 lassen sich Gesichtsbewegungen eines realen Menschen präzise auf einen digitalen Metahuman-Charakter übertragen. Voraussetzung dafür ist ein iPhone mit integrierter TrueDepth-Kamera, das über ein lokales Netzwerk mit dem Rechner verbunden wird, auf dem Unreal Engine läuft. In diesem Tutorial wird gezeigt, wie die Live Link Face App eingerichtet und mit der Engine verbunden wird, wie der Metahuman korrekt vorbereitet wird und wie schließlich die Gesichtsdaten live übertragen werden. Ziel ist es, eine funktionierende Echtzeitverbindung herzustellen, bei der sich der Metahuman synchron zur Mimik der realen Person bewegt. ...