Analyse unstrukturierter Dokumente mit "Unstructured"
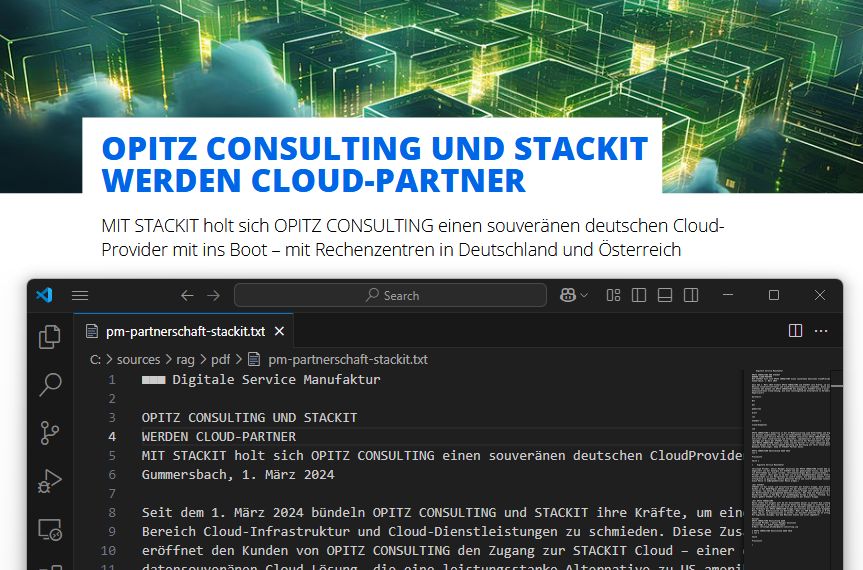
Im Rahmen dieses Tests wird das Open-Source-Framework unstructured eingesetzt, um den Extraktionsprozess von Text aus strukturierten Dokumenten zu evaluieren. Ziel ist es, zu prüfen, inwieweit sich unstructured für den praktischen Einsatz in KI-basierten Informationssystemen eignet – insbesondere mit Blick auf die Textextraktion, semantische Aufbereitung (Chunking/Tokenisierung) und anschließende Embedding-Erzeugung für Vektor-basierte Retrieval-Systeme. Hier sieht man ein Beispiel einer PDF-Datei, die für die Analyse mit unstructured verwendet wurde. pm-partnerschaft-stackitHerunterladen Zur Ausführung der unstructured-Bibliothek wird das offizielle Docker-Image verwendet. Dieses enthält alle erforderlichen Abhängigkeiten (z. B. Tesseract, Poppler, Python-Bibliotheken) und ermöglicht eine sofortige Nutzung ohne lokale Python-Installation. ...