Beim Untergang der Titanic im April 1912 starben mehr als die Hälfte der Menschen an Bord. Die Plattform Kaggle stellt für 891 Passagiere eine Tabelle bereit, die zeigt, wer überlebt hat. Dieser Beitrag wertet die Tabelle mit R aus: Wie hängen Geschlecht, Klasse und Alter mit dem Überleben zusammen? Zeilen, die mit #> beginnen, zeigen die Ausgabe von R.
Daten laden
Datensatz herunterladen
Die Daten gehören zum Kaggle Wettbewerb Titanic: Machine Learning from Disaster. Für den Download braucht man ein kostenloses Konto bei Kaggle. Die Datei train.csv enthält die 891 Passagiere, deren Schicksal bekannt ist.
Ohne Konto geht es mit dem R Paket titanic. Es enthält dieselbe Tabelle unter dem Namen titanic_train:
install.packages("titanic")
train <- titanic::titanic_train
Datensatz einlesen
In der Datei fehlen bei manchen Passagieren das Alter, die Kabine oder der Hafen. na.strings sorgt dafür, dass R leere Felder als fehlenden Wert NA einliest und nicht als leeren Text.
train <- read.csv("train.csv", na.strings = c("", "NA"))Aufbau der Daten
dim(train)          # Zeilen und Spalten
#> [1] 891  12
str(train)
#> 'data.frame':	891 obs. of  12 variables:
#>  $ PassengerId: int  1 2 3 4 5 6 7 8 9 10 ...
#>  $ Survived   : int  0 1 1 1 0 0 0 0 1 1 ...
#>  $ Pclass     : int  3 1 3 1 3 3 1 3 3 2 ...
#>  $ Name       : chr  "Braund, Mr. Owen Harris" "Cumings, Mrs. John Bradley (Florence Briggs Thayer)" "Heikkinen, Miss. Laina" "Futrelle, Mrs. Jacques Heath (Lily May Peel)" ...
#>  $ Sex        : chr  "male" "female" "female" "female" ...
#>  $ Age        : num  22 38 26 35 35 NA 54 2 27 14 ...
#>  $ SibSp      : int  1 1 0 1 0 0 0 3 0 1 ...
#>  $ Parch      : int  0 0 0 0 0 0 0 1 2 0 ...
#>  $ Ticket     : chr  "A/5 21171" "PC 17599" "STON/O2. 3101282" "113803" ...
#>  $ Fare       : num  7.25 71.28 7.92 53.1 8.05 ...
#>  $ Cabin      : chr  NA "C85" NA "C123" ...
#> $ Embarked : chr "S" "C" "S" "S" ...| Spalte | Bedeutung |
|---|---|
| PassengerId | laufende Nummer |
| Survived | 0 = gestorben, 1 = überlebt |
| Pclass | Klasse: 1, 2 oder 3 |
| Name | Nachname, Anrede und Vorname |
| Sex | Geschlecht: female oder male |
| Age | Alter in Jahren |
| SibSp | Anzahl Geschwister und Ehepartner an Bord |
| Parch | Anzahl Eltern und Kinder an Bord |
| Ticket | Ticketnummer |
| Fare | Fahrpreis in britischen Pfund |
| Cabin | Kabinennummer |
| Embarked | Hafen der Einschiffung: C = Cherbourg, Q = Queenstown, S = Southampton |
head(train[, c("Survived", "Pclass", "Name", "Sex", "Age", "Fare")])
#>   Survived Pclass                                                Name
#> 1        0      3                             Braund, Mr. Owen Harris
#> 2        1      1 Cumings, Mrs. John Bradley (Florence Briggs Thayer)
#> 3        1      3                              Heikkinen, Miss. Laina
#> 4        1      1        Futrelle, Mrs. Jacques Heath (Lily May Peel)
#> 5        0      3                            Allen, Mr. William Henry
#> 6        0      3                                    Moran, Mr. James
#>      Sex Age    Fare
#> 1   male  22  7.2500
#> 2 female  38 71.2833
#> 3 female  26  7.9250
#> 4 female  35 53.1000
#> 5   male  35  8.0500
#> 6   male  NA  8.4583
colSums(is.na(train))   # fehlende Werte je Spalte
#> PassengerId    Survived      Pclass        Name         Sex
#>           0           0           0           0           0
#>         Age       SibSp       Parch      Ticket        Fare
#>         177           0           0           0           0
#>       Cabin    Embarked
#>         687           2
Beim Alter fehlen 177 Werte, bei der Kabine 687. Alle Auswertungen zum Alter beziehen sich deshalb nur auf die 714 Passagiere mit bekanntem Alter.
Damit die Tabellen lesbar werden, bekommt die Spalte Survived eine Beschriftung:
train$Status <- factor(train$Survived, levels = c(0, 1),
                       labels = c("gestorben", "überlebt"))
Überlebende insgesamt
table(train$Status)
#>
#> gestorben  überlebt
#>       549       342
round(prop.table(table(train$Status)) * 100, 1)   # in Prozent
#>
#> gestorben  überlebt
#>      61.6      38.4
342 Passagiere haben überlebt, das sind 38 Prozent. 549 Passagiere sind gestorben.
anzahl <- table(train$Status)
pie(anzahl,
    labels = paste0(names(anzahl), ": ", anzahl, " Personen"),
    col = c("#c0392b", "#27ae60"),
    main = "Überlebende und gestorbene Passagiere")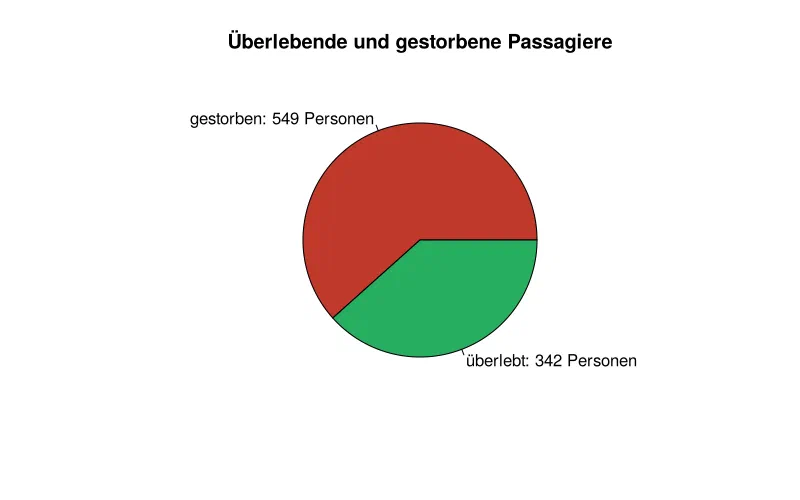
Geschlecht
Passagiere nach Geschlecht
table(train$Sex)
#>
#> female   male
#> 314 577barplot(table(train$Sex),
names.arg = c("Frauen", "Männer"),
col = c("#e377c2", "#1f77b4"),
ylab = "Anzahl Passagiere", ylim = c(0, 600),
main = "Passagiere nach Geschlecht")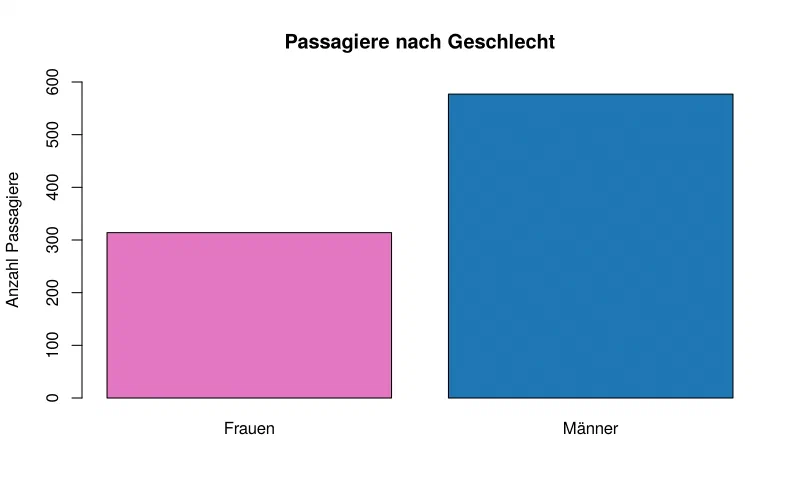
Überleben nach Geschlecht
table(train$Sex, train$Status)
#>
#>          gestorben überlebt
#>   female        81      233
#> male 468 109barplot(table(train$Sex, train$Status),
beside = TRUE,
col = c("#e377c2", "#1f77b4"),
ylab = "Anzahl Passagiere", ylim = c(0, 500),
legend.text = c("Frauen", "Männer"),
args.legend = list(x = "topright"),
main = "Überlebende und Gestorbene nach Geschlecht")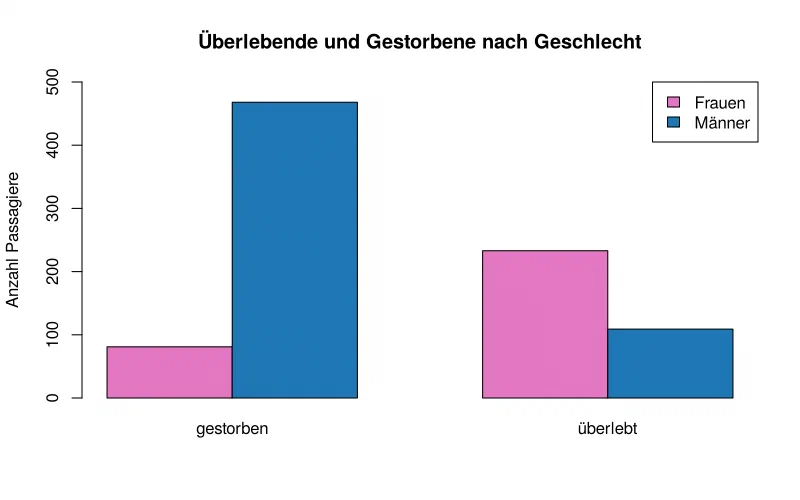
prop.table() rechnet die Tabelle in Anteile um. Ohne weitere Angabe beziehen sich die Anteile auf alle 891 Passagiere:
round(prop.table(table(train$Sex, train$Status)) * 100, 1)
#>
#>          gestorben überlebt
#>   female       9.1     26.2
#>   male        52.5     12.2
Mit margin = 1 beziehen sich die Anteile auf jede Zeile, hier also getrennt auf alle Frauen und auf alle Männer:
round(prop.table(table(train$Sex, train$Status), margin = 1) * 100, 1)
#>
#>          gestorben überlebt
#>   female      25.8     74.2
#>   male        81.1     18.9
74 Prozent der Frauen haben überlebt, aber nur 19 Prozent der Männer. Das entspricht der Regel „Frauen und Kinder zuerst“ beim Besetzen der Rettungsboote.
Klasse
Passagiere nach Klasse
table(train$Pclass)
#>
#>   1   2   3
#> 216 184 491
table(train$Status, train$Pclass)
#>
#>               1   2   3
#>   gestorben  80  97 372
#> überlebt 136 87 119tab <- table(train$Status, train$Pclass)
colnames(tab) <- paste0(colnames(tab), ". Klasse")
dotchart(tab, pch = 19, col = "#1f77b4", gcolor = "#c0392b",
xlab = "Anzahl Passagiere", xlim = c(0, 400),
main = "Überlebende und Gestorbene nach Klasse")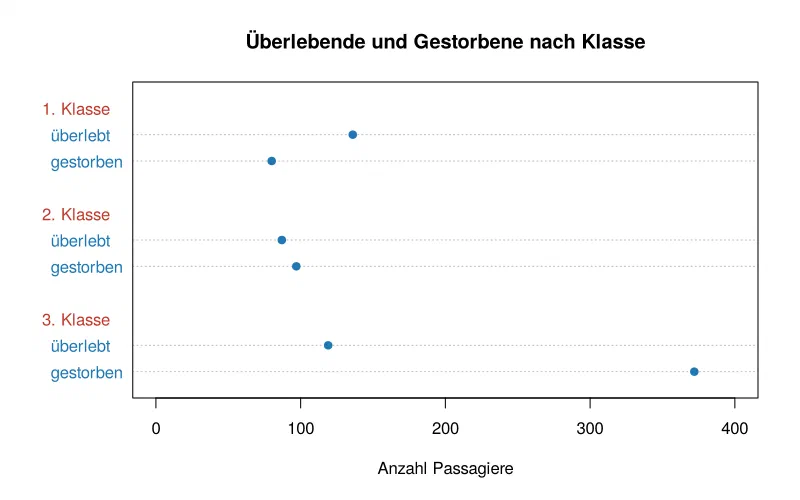
Überlebensrate je Klasse
margin = 2 bezieht die Anteile auf jede Spalte, hier also auf jede Klasse. Das ersetzt die Rechnung von Hand wie 100 / 216 * 136.
round(prop.table(table(train$Status, train$Pclass), margin = 2) * 100, 1)
#>
#>                1    2    3
#>   gestorben 37.0 52.7 75.8
#>   überlebt  63.0 47.3 24.2
In der ersten Klasse haben 63 Prozent überlebt, in der zweiten 47 Prozent und in der dritten 24 Prozent.
Geschlecht und Klasse zusammen
ftable() zeigt eine Tabelle mit drei Merkmalen übersichtlich in Zeilen und Spalten:
ftable(table(train$Pclass, train$Sex, train$Status))
#>           gestorben überlebt
#>
#> 1 female          3       91
#>   male           77       45
#> 2 female          6       70
#>   male           91       17
#> 3 female         72       72
#>   male          300       47
In der ersten und zweiten Klasse haben fast alle Frauen überlebt. In der dritten Klasse war es nur die Hälfte.
aggregate(Survived ~ Pclass + Sex, data = train, FUN = mean)
#>   Pclass    Sex  Survived
#> 1      1 female 0.9680851
#> 2      2 female 0.9210526
#> 3      3 female 0.5000000
#> 4      1   male 0.3688525
#> 5      2   male 0.1574074
#> 6      3   male 0.1354467
Weil Survived nur 0 und 1 enthält, ergibt der Mittelwert direkt die Überlebensrate.
Alter
Altersverteilung
library(ggplot2)
ggplot(train, aes(x = Age)) +
  geom_histogram(binwidth = 5, boundary = 0, fill = "#1f77b4", colour = "white") +
  labs(x = "Alter in Jahren", y = "Anzahl Passagiere", title = "Alter der Passagiere")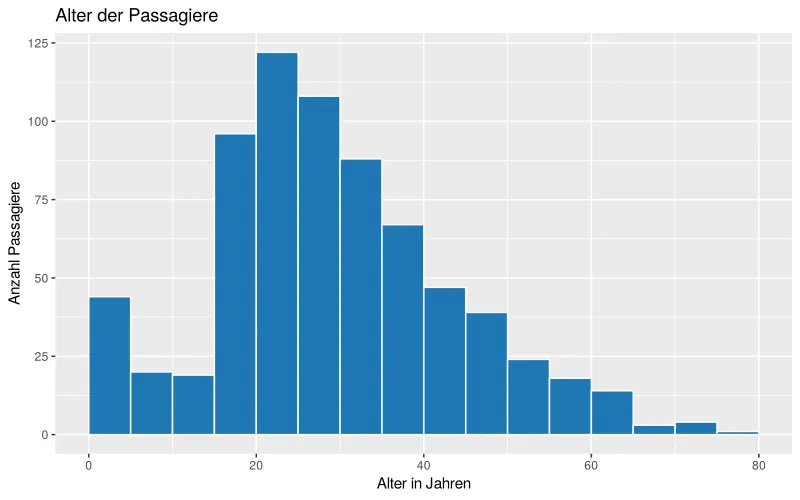
summary(train$Age)
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.    NA's
#>    0.42   20.12   28.00   29.70   38.00   80.00     177
Das Durchschnittsalter liegt bei knapp 30 Jahren. Der jüngste Passagier war 5 Monate alt, der älteste 80 Jahre.
Alter der überlebenden Frauen je Klasse
frauen <- subset(train, Sex == "female" & Status == "überlebt")
aggregate(Age ~ Pclass, data = frauen, FUN = median)
#>   Pclass Age
#> 1      1  35
#> 2      2  28
#> 3      3  19
summary(frauen$Age[frauen$Pclass == 1])
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.    NA's
#>   14.00   23.25   35.00   34.94   44.00   63.00       9
aggregate() mit der Formel Age ~ Pclass lässt Passagiere ohne Altersangabe automatisch weg.
Kinder
Als Kinder gelten hier alle Passagiere unter 18 Jahren.
kinder <- subset(train, Age < 18)
nrow(kinder)
#> [1] 113
table(kinder$Pclass)                       # Kinder je Klasse
#>
#>  1  2  3
#> 12 23 78
table(kinder$Status, kinder$Pclass)        # überlebt und gestorben je Klasse
#>
#>              1  2  3
#>   gestorben  1  2 49
#>   überlebt  11 21 29
In der ersten Klasse starb ein Kind, in der zweiten zwei, in der dritten 49.
maedchen <- subset(kinder, Sex == "female")
table(maedchen$Status, maedchen$Pclass)
#>
#>              1  2  3
#>   gestorben  1  0 16
#>   überlebt   7 12 19
Überlebensrate nach Altersgruppe
train$Altersgruppe <- cut(train$Age, breaks = c(0, 10, 18, 30, 50, 80),
                          labels = c("0 bis 9", "10 bis 17", "18 bis 29",
                                     "30 bis 49", "50 bis 80"),
                          right = FALSE, include.lowest = TRUE)
rate <- aggregate(Survived ~ Altersgruppe + Sex, data = train, FUN = mean)
rate
#>    Altersgruppe    Sex  Survived
#> 1       0 bis 9 female 0.6333333
#> 2     10 bis 17 female 0.7600000
#> 3     18 bis 29 female 0.7282609
#> 4     30 bis 49 female 0.7826087
#> 5     50 bis 80 female 0.9090909
#> 6       0 bis 9   male 0.5937500
#> 7     10 bis 17   male 0.1538462
#> 8     18 bis 29   male 0.1564246
#> 9     30 bis 49   male 0.2134146
#> 10    50 bis 80   male 0.1346154

ggplot(rate, aes(x = Altersgruppe, y = Survived * 100, fill = Sex)) +
  geom_col(position = "dodge") +
  scale_fill_manual(values = c(female = "#e377c2", male = "#1f77b4"),
                    labels = c("Frauen", "Männer"), name = NULL) +
  labs(x = "Alter in Jahren", y = "Überlebensrate in Prozent",
       title = "Überlebensrate nach Altersgruppe und Geschlecht")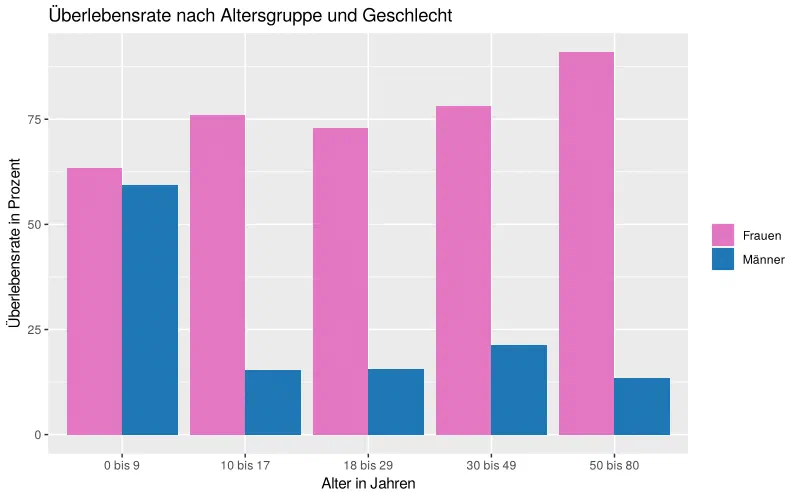
Jungen unter 10 Jahren hatten eine deutlich bessere Chance als erwachsene Männer. Ab 10 Jahren sinkt die Überlebensrate der Jungen auf das Niveau der Männer.
Anrede im Namen
Jeder Name enthält eine Anrede wie Mr, Mrs, Miss oder Master. Master war die Anrede für Jungen. Die Anrede steht zwischen dem Komma und dem ersten Punkt und lässt sich mit einem regulären Ausdruck herauslösen:
anyDuplicated(train$Name)    # 0 bedeutet: kein Name kommt doppelt vor
#> [1] 0

train$Anrede <- sub(".*, *([^.]+)\\..*", "\\1", train$Name)
sort(table(train$Anrede), decreasing = TRUE)
#>
#>           Mr         Miss          Mrs       Master           Dr
#>          517          182          125           40            7
#>          Rev          Col        Major         Mlle         Capt
#>            6            2            2            2            1
#>          Don     Jonkheer         Lady          Mme           Ms
#>            1            1            1            1            1
#>          Sir the Countess
#>            1            1
Seltene Anreden fasst ifelse() unter „Andere“ zusammen:
haeufig <- c("Mr", "Mrs", "Miss", "Master")
train$Anrede <- ifelse(train$Anrede %in% haeufig, train$Anrede, "Andere")
table(train$Anrede)
#>
#> Andere Master   Miss     Mr    Mrs
#>     27     40    182    517    125
Überleben nach Anrede
table(train$Anrede, train$Status)
#>
#>          gestorben überlebt
#>   Andere        15       12
#>   Master        17       23
#>   Miss          55      127
#>   Mr           436       81
#>   Mrs           26       99
round(prop.table(table(train$Anrede, train$Status), margin = 1) * 100, 1)
#>
#>          gestorben überlebt
#>   Andere      55.6     44.4
#>   Master      42.5     57.5
#>   Miss        30.2     69.8
#>   Mr          84.3     15.7
#>   Mrs         20.8     79.2
Anrede und Klasse
ftable(table(train$Pclass, train$Anrede, train$Status))
#>           gestorben überlebt
#>
#> 1 Andere          7       11
#>   Master          0        3
#>   Miss            2       44
#>   Mr             70       37
#>   Mrs             1       41
#> 2 Andere          8        1
#>   Master          0        9
#>   Miss            2       32
#>   Mr             83        8
#>   Mrs             4       37
#> 3 Andere          0        0
#>   Master         17       11
#>   Miss           51       51
#>   Mr            283       36
#>   Mrs            21       21
Alter je Anrede
aggregate(Age ~ Anrede, data = train, FUN = max)
#>   Anrede Age
#> 1 Andere  70
#> 2 Master  12
#> 3   Miss  63
#> 4     Mr  80
#> 5    Mrs  63
Der älteste Junge mit der Anrede Master war 12 Jahre alt.
Information Gain
Der Information Gain gibt an, wie stark ein Merkmal die Unsicherheit über das Ergebnis verringert, hier also über das Überleben. Entscheidungsbäume wählen damit das Merkmal aus, nach dem sie die Daten zuerst aufteilen. Grundlage ist die Entropie: Sie ist 0, wenn alle Werte gleich sind, und 1, wenn zwei Werte gleich häufig vorkommen.
entropie <- function(y) {
  p <- table(y) / length(y)
  p <- p[p > 0]
  -sum(p * log2(p))
}

information_gain <- function(y, x) {
  x <- addNA(factor(x), ifany = TRUE)   # fehlende Werte als eigene Gruppe
  teile <- split(y, x)
  bedingt <- sum(sapply(teile, \(t) length(t) / length(y) * entropie(t)))
  entropie(y) - bedingt
}

entropie(train$Survived)
#> [1] 0.9607079
Die Entropie des Überlebens liegt bei 0.96, weil Überlebende und Gestorbene fast gleich häufig sind.
Merkmale mit vielen verschiedenen Werten
Wendet man den Information Gain auf alle Spalten an, landen Name, Ticket und PassengerId ganz oben:
spalten <- c("PassengerId", "Name", "Ticket", "Cabin", "Sex", "Pclass", "Embarked")
sort(sapply(train[spalten], \(x) information_gain(train$Survived, x)),
     decreasing = TRUE)
#> PassengerId        Name      Ticket       Cabin         Sex
#>  0.96070790  0.96070790  0.82593692  0.23838554  0.21766011
#>      Pclass    Embarked
#>  0.08383105  0.02404709
Das Ergebnis führt in die Irre. Jeder Name kommt nur einmal vor, deshalb sagt der Name das Überleben jedes einzelnen Passagiers perfekt voraus, ohne etwas über einen neuen Passagier zu verraten. Der Information Gain bevorzugt Merkmale mit vielen verschiedenen Werten.
Information Gain Ratio
Das Information Gain Ratio teilt den Information Gain durch die Entropie des Merkmals selbst. Merkmale mit sehr vielen verschiedenen Werten haben eine hohe Entropie und bekommen dadurch einen kleineren Wert:
gain_ratio <- function(y, x) {
  x <- addNA(factor(x), ifany = TRUE)
  information_gain(y, x) / entropie(x)
}

train$KabineBekannt <- !is.na(train$Cabin)
train$Preisgruppe <- cut(train$Fare, breaks = c(0, 10, 30, 100, Inf),
                         right = FALSE)

merkmale <- c("PassengerId", "Name", "Ticket", "Sex", "Anrede", "Pclass",
              "KabineBekannt", "Preisgruppe", "Altersgruppe", "Embarked",
              "SibSp", "Parch")
ergebnis <- data.frame(
  merkmal = merkmale,
  gain    = sapply(train[merkmale], \(x) information_gain(train$Survived, x)),
  ratio   = sapply(train[merkmale], \(x) gain_ratio(train$Survived, x)),
  row.names = NULL
)
ergebnis[order(-ergebnis$ratio), ] |> transform(gain = round(gain, 3),
                                                  ratio = round(ratio, 3))
#>          merkmal  gain ratio
#> 4            Sex 0.218 0.232
#> 5         Anrede 0.239 0.143
#> 1    PassengerId 0.961 0.098
#> 2           Name 0.961 0.098
#> 7  KabineBekannt 0.071 0.092
#> 3         Ticket 0.826 0.089
#> 6         Pclass 0.084 0.058
#> 8    Preisgruppe 0.083 0.047
#> 11         SibSp 0.033 0.025
#> 10      Embarked 0.024 0.022
#> 12         Parch 0.024 0.021
#> 9   Altersgruppe 0.019 0.008
Nach dem Gain Ratio steht das Geschlecht vorn, gefolgt von der Anrede. Name, Ticket und PassengerId verlieren zwar den größten Teil ihres Werts, liegen aber immer noch vor der Klasse. Spalten, die für jeden Passagier einen anderen Wert haben, gehören deshalb vor jeder Auswertung aus der Tabelle. Keine der beiden Kennzahlen gleicht diesen Fehler vollständig aus.
Das Paket FSelector berechnet beide Werte mit information.gain() und gain.ratio(), braucht aber eine Java Installation.